
前言 #
大模型架构五花八门,但想要真正了解一个架构,还是要落到实践中去。YouTube 上还是有很多高质量的网课视频可以学习的,比如 CS336: Language Modeling from Scratch 课程,因此本文也相当于是 CS336 的一个笔记文本,同时也附上我的代码实现和对讲义中问题的解答
“实践是检验真理的唯一标准”🫡
所有的内容整体上可以分为五个部分:
- 基础部分:分词器、可用资源盘点、模型架构、训练思路
- 系统工程:内核、并行、推理
- 规模定律 (很多翻译为"缩放定律",但语义上来说规模定律更确切)
- 数据工程:基准测试与预训练数据工程,脏但非常关键
- 模型对齐:RL 后训练微调
基础部分 #
分词器 #
分词器这部分卡帕西有一个非常好的视频,深入讲解了分词器的各种相关知识。
分词器从功能上来说是一个独立于 Transformer 主体的一个配件,其主要功能是将一长串的文本字符串编码为整数,也就是 Transformer 模型真正能够处理的数据类型:一连串的整数序列。
一个比较有意思的问题是:从底层来看,如果仅仅只是为了将字符映射为整数的话,数字化的文本其实并不需要进行特意进行编码,因为绝大部分数字文本都使用 UTF-8 进行编码,这些字符在计算机底层天然就是被整数编码的。
>>> test_string = "hello, 世界!"
>>> utf8_encoded = test_string.encode("utf-8")
>>> print(utf8_encoded)
b'hello, \xe4\xb8\x96\xe7\x95\x8c\xef\xbc\x81'
>>> list(utf8_encoded)
[104, 101, 108, 108, 111, 44, 32, 228, 184, 150, 231, 149, 140, 239, 188, 129]
从上面这个例子看来,一个非常简短的文本被编码为了 16 个整数,但很明显这个编码太琐碎了。Transformer 的注意力窗口大小有限并且非常昂贵,因此分词器的作用就是将琐碎的底层编码进行分块聚合,从而减少分词后的整数序列长度,提高模型的计算效率。
一个值得关注的问题是:假设我们有充足的算力资源,直接在 UTF-8 序列上进行训练效果会不会更好?或者说我们可将 Tokenizer 视作一次简单的空间映射,将数据从嘈杂的 UTF-8 编码的空间中映射到一个更有语义的空间中。我们已经知道这种映射的有效性,毕竟所有主流大模型都是如此训练的,但具体有多少改进以及能否理论量化?
从具体算法上来说,一般都使用的是 OpenAI 当初使用的 BPE 算法,具有代表性的算法库就是 tiktoken。当然 Google 使用的算法库 sentencepices 也是被众多大模型采用的,但配置相比于 tiktoken 确实是复杂很多。
细节问答 #
- 为什么需要使用字节编码而不是直接使用 UTF-8 编码?
答:直接使用 UTF-8 得到的词表非常大,实际数据在词表上的分布极其稀疏(很多词汇几乎没有使用过);使用字节编码词表大小只有 256,实际数据在词表上的分布更密集。但并不是说字节编码没有缺点,要用如此少的词表来表达所有字符意味着需要很大的序列长度,这会增大模型的计算负担,实际使用的 BPE 就是这两者之间的平衡。
- 为什么要进行预分词?
答:原始的 BPE 算法复杂度非常高,每一轮合并都需要遍历语料库;并且这种方式会产生一些只有标点符号不同的 token 这不便于模型学习(dog! vs dog.)
- 运行内存受限的情况下如何处理大数据集?
答:在 RAM 资源受限的情况下,如果想要在大数据集上完成训练就需要使用懒加载的文件读取方式(mmap),这样能够有效控制峰值内存,必要时还需要完成从文件读取到编码再到写盘全流程的流式懒加载策略。同时,数据结构与算法在分词器这个环节应用非常多,个人体验上使用最多的就是优先队列和哈希表。
可用资源盘点 #
大体上可用资源可以分为:单位时间计算能力(FLOP/s)、时间、数据量、内存大小、张量计算操作的算力消耗;资源盘点的作用就是根据已知的资源约束去估计训练用时或者估计能够训练出来的最大的模型参数量。
内存占用 #
几乎所有的数据都是使用张量进行存储的,也就是一堆按照规则排列的浮点数。根据浮点数格式的不同,模型训练或推理占用的内存大小也不相同。一般来说浮点数的格式有如下几种:
- float32:32-bit float,占用 4B 的内存空间

- float16:16-bit float,占用 2B 的内存空间,动态范围相比 float32 小,在反向传播算法产生的梯度非常小的情况下会产生数值下溢(这也是 bfloat16 产生的原因)

- bfloat16:brain floating point,同样占用 2B 空间,通过牺牲分辨率来扩大动态范围,尽量减少奇怪的数值溢出问题(深度学习中分辨率没那么重要)

实际工程中一般都使用混合精度进行训练:float32 用于优化器状态,bfloat16 用于参数、激活值和梯度。当然了,还有一些更加激进的精度表示方式比如 float8, float4 但实际上模型的训练一般不会用。并且 float4 在使用的时候也不会直接用于表示一个参数值,而是与相邻的参数值打包共享一个精度缩放参数,这种操作的有效性依赖于参数的局部相似性,也就是相邻的参数可能具有相近的数量级,于是可以将公共的数量级提取出来从而用一批低精度的数配合缩放参数表达一批高精度的数。
量化是将一个高精度训练的模型对齐到一个低精度的模型空间中,其实现难度比直接在低精度上训练模型更低
这里对 MLP 进行一个粗略的内存占用量估计,假设输入、激活和输出都有一个固定的维度 D,网络层数为 L,批量大小为 B,那么总的参数量可以估计为 \(D^2\cdot L\) 也就是有 L 层 \(D\times D\) 方阵;参数占用内存为 \(2D^2\cdot L\) 字节因为每一个参数我们假设使用 bf16 格式进行存储,梯度占用内存与参数占用一致(只有参数才需要梯度并且每一个参数都需要一个梯度值),优化器状态则需要 \(4D^2\cdot L\) 字节来存储,因为优化器状态一般都使用 fp32 来保证精度(例如 AdaGrad 优化器中的 g2 参数会作为分母参与学习率的调控需要较高的精度),然后激活值的话就与参数占用一致了即 \(2D^2\cdot L\) 字节
优化器状态会随着优化器的不同而浮动,比如 Adam 优化器会为每一个参数配置 8 字节的内存来保存第一和第二动量值
一些削减内存占用的方法,比如梯度积累,使用一个 micro_batch_size 参数去计算梯度并在 \(\frac{\text{batch\_size}}{\text{micro\_batch\_size}}\) 这么多步内逐步积累梯度,然后再进行参数更新;选择性存储激活值,比如激活前的参数和激活后的参数可以只存储其中的激活前数据,需要后激活数据可以临时计算,更激进的做法甚至会跨越矩阵乘法进行省略,但速度肯定会慢许多就是了。
这里详细给出 Transformer 中一些特色模块的峰值内存上界,因为是求上界所以这里就简单地将训练过程中需要保存的数据全部加起来(实际运行时会有动态的内存释放,会比上界更小),并忽略一些使用临时计算来降低内存的优化操作(在计算梯度时有些中间变量就会重算,因为重算的开销更小)
从整体上来说,峰值内存可以划分为四个部分:可训练参数(权重)、优化器状态(取决于优化器种类,下文默认使用 AdamW 优化器)、梯度值、激活值。前三个都很好理解:可训练参数本身就写在代码里面的,AdamW 优化器每个参数都有第一和第二动量也就是可训练参数量的两倍,梯度值每一个可训练参数都有一个梯度。但是激活值具体是什么?激活值是求梯度值的过程中需要使用的中间变量(比如输入张量),与梯度的计算过程强耦合,并且还有动态重算机制来节约内存,因此一般认为每一步基本操作的产出都会计入激活值。
RMSNorm:含有一个 \(d_{\text{model}}\) 的可训练缩放参数,优化器占用 \(2 \times d_{\text{model}}\) 的参数量,梯度需要 \(d_{\text{model}}\) 参数,激活值只需要输入张量一个即可,也就是 \(\text{batch\_size}\times \text{context\_length}\times d_{\text{model}}\)
多头自注意力:默认 \(d_{k}=\frac{d_{\text{model}}}{\text{num\_heads}}\),可训练参数也就是 \(W_{Q}\) \(W_{K}\) \(W_{V}\) 三个矩阵,每个矩阵都是 \(d_{\text{model}}\times d_{\text{model}}\) 的形状;优化器是两倍可训练参数量即 \(6\times d_{\text{model}}\times d_{\text{model}}\) 的参数量;梯度与可训练参数一致有 \(3\times d_{\text{model}}\times d_{\text{model}}\) 的参数量;激活值包括输入张量 \(\text{batch\_size}\times \text{context\_length}\times d_{\text{model}}\), \(Q\) \(K\) \(V\) 三个投影张量,每一个投影张量都是 \(\text{batch\_size}\times\text{contex\_length}\times d_{\text{model}}\),注意力打分和 softmax 都产出 \(\text{batch\_size}\times \text{num\_heads} \times \text{contex\_length}\times \text{contex\_length}\) 形状的张量(二次项),加权线性求和 \(\text{batch\_size}\times \text{context\_length}\times d_{\text{model}}\),输出层线性投影同样为 \(\text{batch\_size}\times \text{context\_length}\times d_{\text{model}}\)
FFN:一般来说 \(d_{ff} = \frac{8}{3}\times d_{\text{model}}\) 因此可训练参数量为 \(3 \times (\text{d\_model} \times d_{ff}) = 8 \times \text{d\_model}^2\);梯度和优化器状态则分别为 \(8 \times \text{d\_model}^2\) 和 \(16 \times \text{d\_model}^2\);激活值包括输入张量 \(\text{batch\_size}\times \text{context\_length}\times d_{\text{model}}\) 和三个投影矩阵的计算结果 \(3 \times (\text{batch\_size} \times \text{context\_length} \times \frac{8}{3} \text{d\_model}) = 8 \times \text{batch\_size} \times \text{context\_length} \times \text{d\_model}\)
张量计算 #
张量乘法的计算量,以下面这张图的计算为例
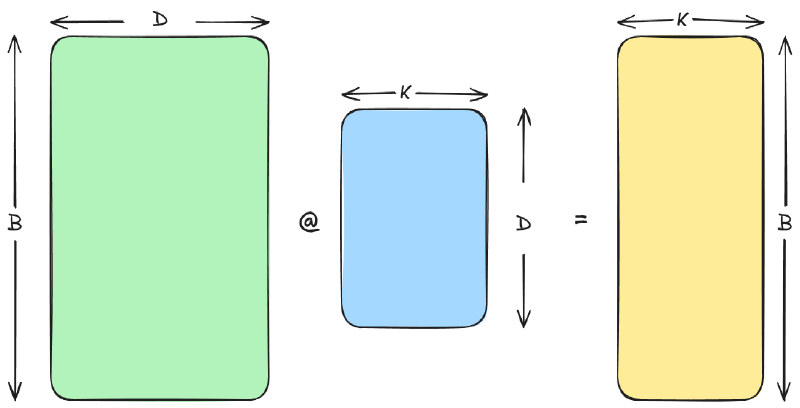
总计算量的计算思路:最终得到的张量为 \(B\times K\) 的形状,总共有 \(B\cdot K\) 个元素,每个元素都是由 \(D\) 组元素相乘最后求和得到,也就是最终结果的每个元素都代表了 \(2D\) 的乘法或加法计算量。因此总计算量为:\(2D\cdot B\cdot K\)
这里考虑的是最简单的情况,不包含任何硬件的优化,比如所有的加法可以压缩为一次加法等等
这里还有一个比较重要的工程优化指标:MFU(Model FLOPs Utilization),表示实际模型运行时的算力利用率。可以简单理解为:在实际工程实现中,整个 GPU 的算力并没有被 100% 利用,实际利用率就是 MFU
在计算反向传播的时候,由于需要同时计算前向传播中两个变元的梯度,所以反向传播的计算量大致是前向传播的两倍。
模型架构 #
标准 Transformer 作为一个 2017 年被提出的模型,从某种程度上说已经有点年头了,所以实际工程中实现的 Transformer 模型都是经过"现代化"改良的变体。大致的改动对比图如下所示。
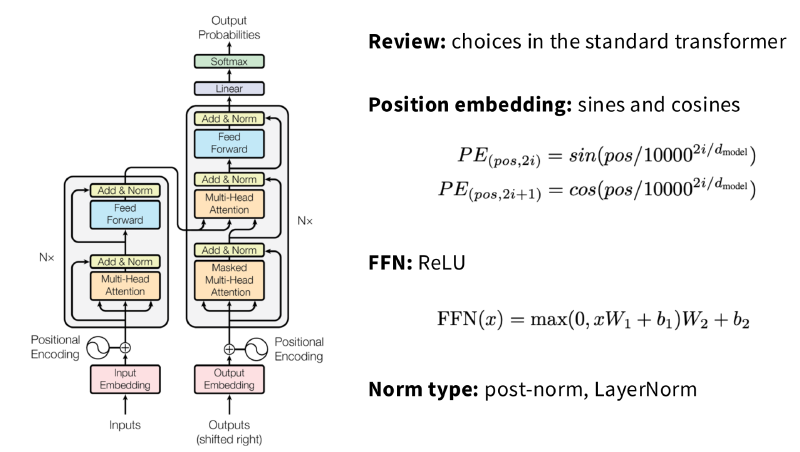
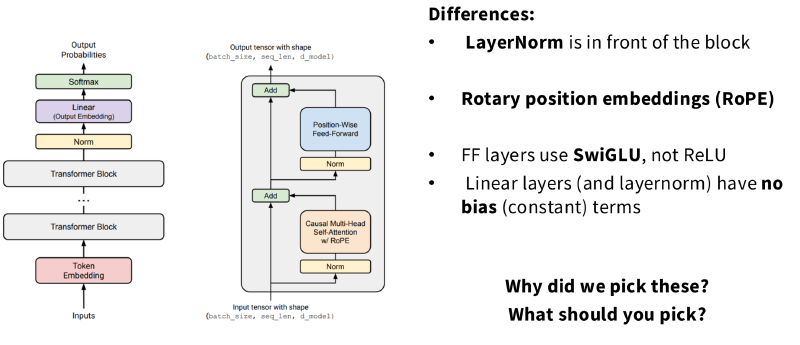
在最终输出部分有一个值得注意的点,那就是最后输出张量的形状,根据经验最终得到的应该是对整个词表的词汇的概率分布也就是 \(\text{batch\_size}\times \text{vocab\_size}\) 的一个张量,但实际上输出的应该是 \(\text{batch\_size} \times \text{seq\_len} \times \text{vocab\_size}\) 也就是对每一个位置的 token 都预测下一个词的分布(这正是 Transformer 高度并行化训练的由来)。猜你想问,那么推理的时候不会很浪费吗?实际上推理的时候只需要最后一个 token 上的概率分布。是的,如果直接照搬训练的逻辑确实很浪费,但推理的时候有 KV Cache 技术,所以只有在生成首个 token 的时候会产生浪费,后续逐 token 生成的时候会直接令序列长度为固定的 1 不变,因为本身也没必要再重复传入先前的序列。
归一化 #
首先,后归一化变为了前归一化,更有利于数值上的稳定性;其中的关键是把归一化从残差流中去掉,层归一化在线性层模块之前还是之后都可以,甚至可以做 “Double-Norm”
然后就是归一化函数的选择,早期的 LLM 一般都使用标准的 LayerNorm 公式,例如 GPT3/2/1
$$ y=\gamma\frac{x-E(x)}{\sqrt{ Var(x)+\epsilon }} + \beta $$而更近期的模型则选择的是 RMSNorm,完全去掉了其中的均值和偏置项
$$ y=\gamma\frac{x}{\sqrt{ \left \| x \right \|_{2}^2 }} $$那么为什么要使用 RMSNorm 呢?因为两者在最终训练结果上并没有差别(甚至 RMSNorm 效果略好),但是 RMSNorm 显然要更快。但为什么要优化这个模块呢?实际上归一化所消耗的 FLOPs 只有 \(0.17\%\) 占比非常可怜按理说没必要优化这个才对,但实际上归一化在实际执行时间中的占比高达 \(25.5\%\) 因为这部分涉及到较高的数据搬运成本。
最后就是丢弃掉线性层中的偏置项,原本的 FFN 层表达式为:
$$ \text{FFN}(x) = max(0, xW_{1}+b_{1})W_{2}+b_{2} $$但最新的实现一般都是:
$$ \text{FFN}(x) = \sigma(xW_{1})W_{2} $$这种操作的原因主要是节省内存并提高训练稳定性。训练稳定性相关内容见训练稳定性小节。
激活函数 #
目前各种各样的激活函数层出不穷,但选择哪种激活函数还是有考究的。目前的 LLM 模型一般都选择带有门控机制的激活函数,所谓的门控机制其实就是一个逐元素相乘(Hadamard product, \(\otimes\)),下面是一个具体的对比例子。经典的 FF 层表达式如下:
$$ \text{FF} = max(0, xW_{1})W_{2} $$而带有门控机制的 ReGLU 就是在 ReLU 部分使用另外的参数进行了门控调节
$$ \text{FF}_{\text{ReGLU}}(x, W_{1}, V, W_{2}) = (max(0, xW_{1})\otimes xV)W_{2} $$参数矩阵 \(V\) 的每个元素会作用在对应的 ReLU 输出中,去放大或者收缩某一个激活值。类似的,就有 GeGLU 和 SwiGLU 激活函数的表达式:
$$ \text{FF}_{\text{GeGLU}}(x, W_{1}, V, W_{2}) = (\text{GeLU}(xW_{1})\otimes xV)W_{2} $$$$ \text{FF}_{\text{SwiGLU}}(x, W_{1}, V, W_{2}) = (\text{Swish}(xW_{1})\otimes xV)W_{2} $$其中 \(\text{Swish}(x) = x\cdot\text{sigmoid}(x)\) 与 GeLU 和 ReLU 类似都是一些基础的激活函数。
最终经过实验发现,门控激活函数确实是有效果的,尽管效果并不太大,例如 ReLU \(83.80\%\) 到 ReGLU \(84.67\%\) 只有不到 \(1\%\) 的提升,但这部分提升几乎没有代价(显存和计算开销都不大),所以这是一个免费午餐为何不要呢?
由于门控激活函数引入了额外的一个投影参数矩阵,因此这些投影矩阵的维度一般都是非门控激活函数的 \(\frac{2}{3}\) 这样能够保持参数量的一致性
层并行 #
标准 LLM 中的 Transformer Blocks 一般都是串行堆叠的,换言之就是下面这个表达式:
$$ y = x+\text{MLP}(\text{Norm}(x+\text{Attention}(\text{Norm}(x)))) $$但 GPT-J 模型就提出了 Transformer 模块两两并行的计算方式:
$$ y = x + \text{MLP}(\text{Norm}(x)) + \text{Attention}(\text{Norm}(x)) $$虽然在 GPT-J 的论文中,说明这种并行方法在大规模训练中能够带来 \(15\%\) 的速度收益,并且在 8B 量级有可控的质量损失,在 62B 量级的模型上则没有损失,换言之这个方法对模型质量的影响是中性的。但事实上绝大部分的模型还是选择了串行连接 Transformer 模块,毕竟这种并行的方法从逻辑上来讲是将模型的深度砍掉了一半,算是一个非常冒险的改动了。
位置编码 #
目前最为主流的位置编码方式就是旋转位置编码了,Rotary Position Embeddings(RoPE),其也是一种相对位置编码,与 token 的绝对位置无关。为什么需要相对位置编码呢?因为 Transformer 中的注意力机制逻辑上应该只依赖 token 之间的相对位置,而绝对位置信息不应该被注意力机制捕获并用于逻辑推断。
在 RoPE 之前也有一些相对位置编码的方案,但是大都面临计算成本高昂或者将不利于 KV Cache 实现等等缺点。理想中的相对位置编码:我可以按照绝对位置的方式应用到每一个 token 上,当计算注意力(内积)的时候就自动变为相对位置的函数。那么什么数学操作能够满足这两个条件呢?答案就是平面矢量的旋转,如下图所示
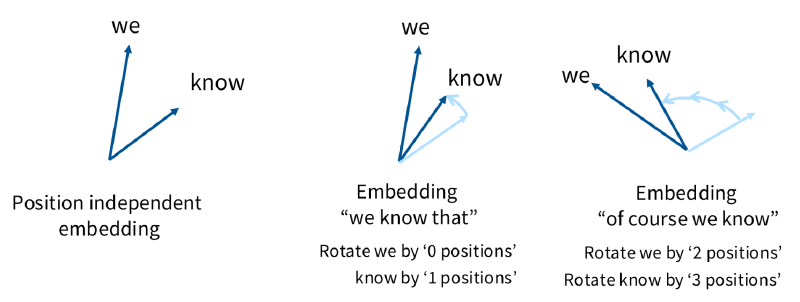
猜你想问:一个二维的向量当然可以这么旋转了,那么高维的向量怎么旋转呢?很难想象一个四维的矢量应该怎么旋转才能够满足上面的条件。但实际上我们没必要真的去旋转一个高维向量,因为最终还是要进行内积,所以大可以将高维矢量的分量两个一组当成平面矢量来处理。具体数学公式如下,引入两个索引参数 \(i\in\{0, 1, \dots ,\text{max\_seq\_len}-1\}\) 表示 token 的绝对位置索引(最多处理 \(\text{max\_seq\_len}\) 个 token),\(k \in \{0,1, \dots ,\frac{d}{2}-1\}\) 表示 \(d\) 维的 token 嵌入向量按照两个一组划分后的组编号。
$$ \theta_{i,k} = \frac{i}{\Theta^{\frac{2k}{d}}} $$$$ R_k^i = \begin{pmatrix} \cos(\theta_{i,k}) & -\sin(\theta_{i,k}) \\ \sin(\theta_{i,k}) & \cos(\theta_{i,k}) \end{pmatrix} $$$$ R^i = \begin{pmatrix} R_1^i & 0 & 0 & \dots & 0 \\ 0 & R_2^i & 0 & \dots & 0 \\ 0 & 0 & R_3^i & \dots & 0 \\ \vdots & \vdots & \vdots & \ddots & \vdots \\ 0 & 0 & 0 & \dots & R_{d/2}^i \end{pmatrix} $$具体代码实现的时候则一般不会直接存储 \(\text{max\_seq\_len}\) 个 \(R^i\) 矩阵,一个更好的方法是单独存储正弦值和余弦值矩阵,两个都是二维的稠密矩阵并且可以全局复用,计算的时候将输入进行变换然后直接应用逐元素乘法即可。一个简单的理解性的例子就是,对二维向量 \([x_0, x_1]^\top\) 旋转 \(\theta\) 角:
$$ \begin{pmatrix} \cos\theta & -\sin\theta \\ \sin\theta & \cos\theta \end{pmatrix} \begin{pmatrix} x_0 \\ x_1 \end{pmatrix} = \begin{pmatrix} x_0 \cos\theta - x_1 \sin\theta \\ x_1 \cos\theta + x_0 \sin\theta \end{pmatrix} $$我们可以把它改写成逐元素相乘的形式:
$$ x \odot \cos(\theta) + \tilde{x} \odot \sin(\theta) $$其中 \(\tilde{x} = [-x_1, x_0, -x_3, x_2, \dots]\),把相邻元素两两交换位置并加个负号,这个结果可以使用批量化的矩阵操作得到。
超参数选择 #
超参数的选择一般是关于这几个问题:
- FF 层的维度 \(d_{\text{ff}}\) 应该设置为多少倍的模型维度 \(d_{\text{model}}\)?
- 多头注意力的头数如何选择?是否应该有严格的 \(d_{\text{model}} = d_{\text{head\_num}} \cdot d_{\text{head}}\) 成立?
- 模型的宽度和深度的比例如何选择?
- 词表大小如何选择?
- 在数据量远超模型参数量的情况下是否必要做正则化来防止过拟合?
首先,\(d_{\text{ff}} = 4d_{\text{model}}\) 这个关系在目前绝大部分模型上都是真实存在的,只有极少数的例外,比如 GLU 变体的 FF 层,由于其引入的第三个投影矩阵,其 \(d_{\text{ff}}\) 是标准的 \(\frac{2}{3}\) 所以在这个变体系列中 \(d_{\text{ff}} = \frac{8}{3}d_{\text{model}}\) ,从某种意义上来讲甚至不算是一个特例。真正的特例其实是 Google 的 T5 模型,其 \(d_{\text{ff}} = 64d_{\text{model}}\) 非常夸张,但论文中对此的描述则是出于对 TPU 利用率的考虑才这么设置的。
然后是注意力头的数量选择,绝大部分时候都有 \(d_{\text{model}} = d_{\text{head\_num}} \cdot d_{\text{head}}\) 成立,最大的意外还是某些 Google 的模型。
你可能会疑惑,如果 \(d_{\text{model}} \neq d_{\text{head\_num}} \cdot d_{\text{head}}\) 那么 token 嵌入的维度不就变化了吗?怎么还能够输入到下一个 Transformer Block 里面呢?这个问题只需要再在最终输出外面套一层线性层 \(W_{O}\) 将输出维度重新调整为 \(d_{\text{model}}\) 就行了,当然这个 \(W_{O}\) 还有一个作用就是混合不同注意力头产出的结果的作用,因此即便 \(d_{\text{model}} = d_{\text{head\_num}} \cdot d_{\text{head}}\) 的时候也会套一层 \(W_{O}\)
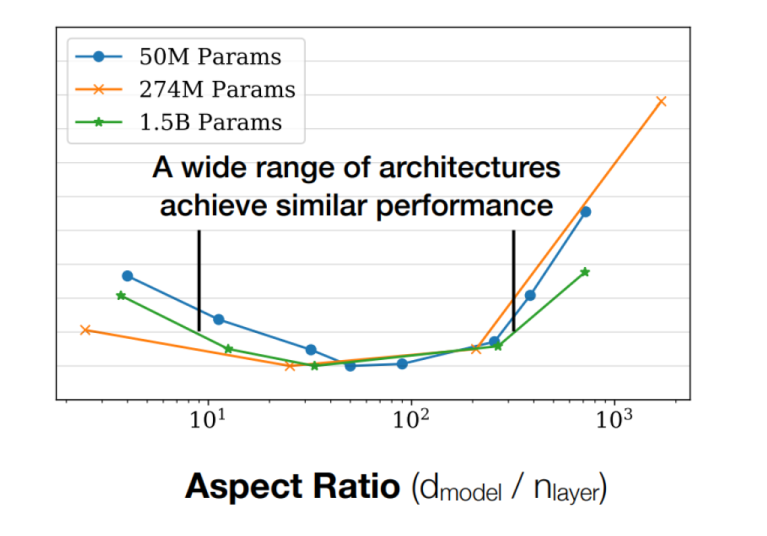
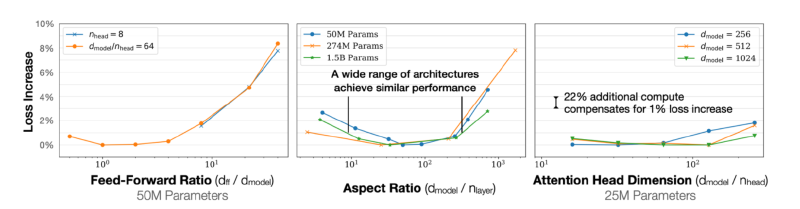
模型的宽深比,同样也是大量的统计数据标明,\(d_{\text{model}}/n_{\text{layer}} = 128\) 左右是一个比较好的权衡,因为模型并不是越深越好,极度深的模型难以并行化具有非常高的延时。
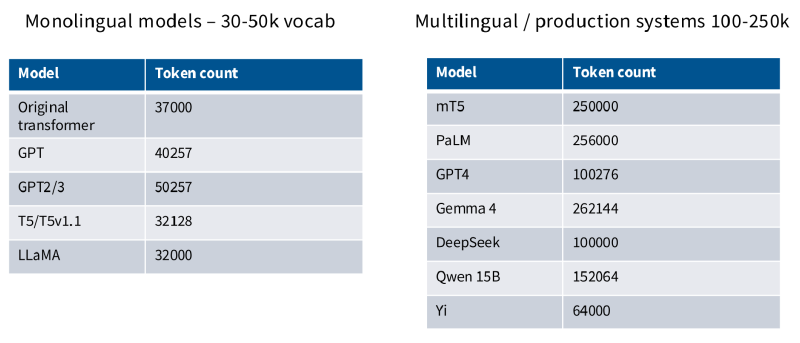
词表大小这个问题需要分单语言模型和多语言模型两种情况,单语言模型一般 30-50k,多语言模型词表会达到 100-250k;题外话,一个具有多模态生成能力的 Trasformer 的词表则更大。
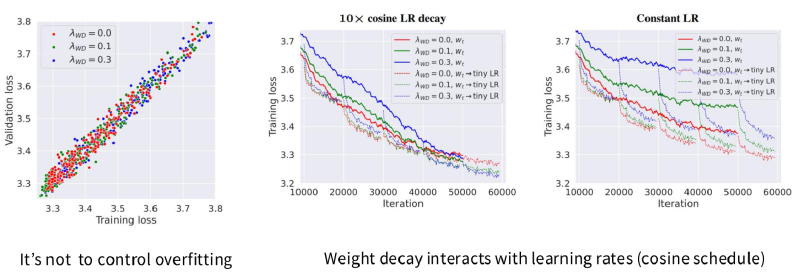
过拟合和正则化的问题,逻辑上来说应该是不需要考虑过拟合的问题:数据量远超参数量,一般而言根本就不会出现过拟合现象;SGD 类型的优化算法在语料上只会进行一遍训练,模型也很难记住文本片段。而实际上 Dropout 方法确实逐渐被取消了,但是权重衰减方案却一直得到了保留:尽管在大部分情况下权重衰减方案都比非衰减方案更糟糕,但是当配合上动态的小学习率的时候在最终结果上能够反超非衰减方案(下面第二张图最右下角部分蓝色虚线实现了最优的训练损失)
训练稳定性 #
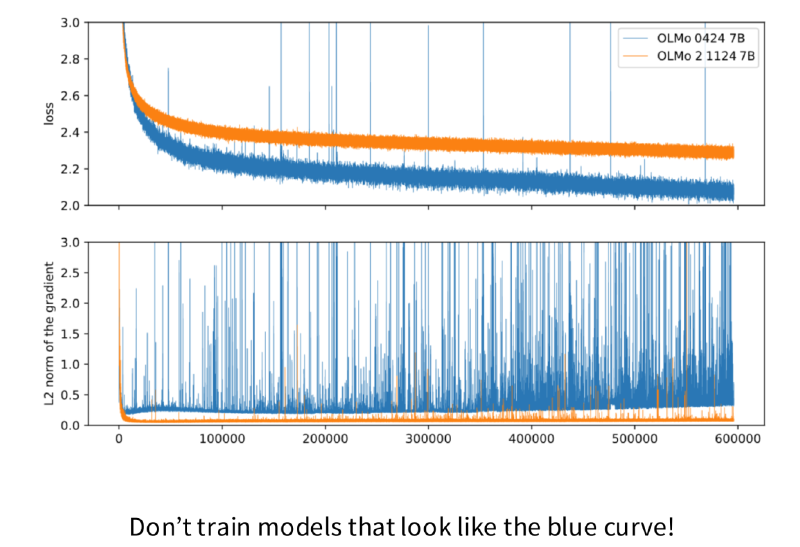
练稳定性是什么 ,听上去有点神乎其神的对吧?下面这张图就是非常好的示意,图中蓝色曲线虽然 loss 值更低但是常常会出现糟糕的峰值,这意味着在训练结束的时候可能会得到一个非常糟糕的模型,图中蓝色的曲线就是典型的训练不稳定。
这种训练不稳定从何而来?首先是模型输出处的 softmax 函数,由于 softmax 函数具有平移不变性,因此优化器没有任何动力去降低打分函数的绝对数值,很容易造成数值溢出。下面是一个标准的交叉熵损失:
$$ \begin{aligned} \text{Loss} &=-\sum_{i}^{L} \left[ \log(P(x_i)) \right] \\ &=-\sum_{i}^{L} \left[ \log\left(\frac{e^{U_r(x_{i})}}{Z(x_{i})}\right) \right] \\ &=-\sum_{i}^{L} \left[ U_r(x_{i}) - \log(Z(x_{i})) \right] \end{aligned} $$$$ Z(x)=\sum_{r'=1}^{|V|} e^{U_{r'}(x)} $$其中的 \(U_{r}\) 函数表示打分函数,\(|V|\) 表示词表大小,\(L\) 表示序列长度。交叉熵损失公式看着很复杂,其实抛开前面的符号,剩余部分其实就是对数似然。为了显式地告诉优化器去约束所有指数的数值大小,一个直白的正则项就是去约束所有指数项的和,也就是 \(Z(x)\) 函数。于是我们可以在损失值中增加一个 Z-loss 正则项:
$$ \begin{aligned} \text{Loss} &=-\sum_{i}^{L} \left[ \log(P(x_i)) -\alpha(\log(Z(x_i))-0)^2 \right] \\ &=-\sum_{i}^{L} \left[ U_r(x_{i}) - \log(Z(x_{i})) -\alpha\log^2(Z(x_i)) \right] \\ &=\sum_{i=1}^{L} \Big[ \underbrace{\log(Z(x_i)) - U_r(x_i)}_{\text{Cross-Entropy}} + \underbrace{\alpha \log^2(Z(x_i))}_{\text{Z-loss}} \Big] \end{aligned} $$猜你想问,正则项为什么是对数的平方,而不是 \((Z-1)^2\)?这里有一个非常容易混淆的地方,此处的 \(Z\) 函数必须是绝对数值,不能使用扣除最大值技巧(用了最后也需要补回去),这是引入这个正则项的必然要求。换言之,如果需要处理绝对数值的话,就必须要使用 \(\log\) 去将指数变为加法,直接使用 \((Z-1)^2\) 会数值溢出:
$$ \log(Z) = m + \log\left( \sum e^{U_{r} - m} \right),\ m=\text{max}(U_{r}) $$其次是注意力模块中的的 softmax 不稳定,但是这里的解决方法并不是直接在 softmax 上动刀,而是在 QK 输入时进行 Norm 操作,也就是一般而言的 “QK Norm” 方法:标准的 Transformer 注意力模块 QK 在得到之后会直接进行内积,而 “QK Norm” 方法会将 QK 进行归一化后再内积,这样送入到 softmax 部分的数据在数量级上会更加一致。
推理时注意力开销 #
之前的所有讨论基本都关注于模型的训练时,但如果我们需要去部署模型的话,就需要考虑推理时的一些开销,最为显著的就是推理时的注意力开销。先定义这样一个注意力模块,\(d\) 表示模型的隐藏维度,\(b\) 表示批量大小,\(n\) 表示输入序列长度,\(h\) 表示多头注意力的头数,\(k=\frac{d}{h}\) 表示注意力头的维度。
我们首先分析一下训练时注意力模块的算数操作数,输入 \(X\) 的形状为 \(b\times n\times d\),每一个注意力头的形状为 \(d\times k\) 所以说 QKV 投影矩阵计算量为:\(3\times(b\cdot n\cdot d\cdot k)\times h = 3bnd^2\);然后计算 Q 和 K 的外积,由于 QK 的形状都是 \(b\times n\times k\) 所以这一步的计算量为 \(bhkn^2 = bdn^2\),后续还有一些别的计算,但是在 \(d\) 和 \(n\) 较大的时候并不占主导,所以这里就简单地将注意力模块的计算复杂度表示为 \(O(bnd^2+bdn^2)\)
训练时的缓存使用则非常容易计算了首先是输入矩阵和 QKV 矩阵等形状为 \(b\times n \times d\) 的矩阵需要访问内存 \(O(bnd)\),然后是 softmax 需要访问缓存 \(O(bhn^2)\) 以及各种权重参数需要访问缓存 \(d^2\),总的访存复杂度为 \(O(bnd+bhn^2+d^2)\)
所以最终训练时的注意力模块算数强度为 \(O\left( \left( \frac{1}{d+n}+\frac{hn}{d^2+dn}+\frac{d}{bnd+bn^2} \right)^{-1} \right)\),很明显随着序列长度 \(n\) 的增长其算数密集程度会越来越高。
但是推理时则不同,因为推理时必须要顺序输出 token,在推理时我们引入了 KV Cache 技术用来避免重复的计算,所以其计算复杂度和原来保持一致 \(O(bnd^2+bdn^2)\) 但是访存复杂度变为了 \(O(bn^2d+d^2)\)
训练时的算数强度会随着序列长度 \(n\) 的增长而收敛至 1,这是一个非常弱的算数强度 A100 上满载的算数强度为 156 左右,换言之 LLM 推理是典型的数据密集型任务。
想要削减内存的访问强度可以使用 GQA 技术,可以对注意力头进行分组,让同组的注意力头共享一组 KV Cache,如果用 \(g\) 表示分组的个数的话,那么 GQA 可以将访存复杂度变为 \(O\left( \frac{1}{g}bn^2d+d^2 \right)\)
另外还有一种技术用于降低注意力的计算复杂度,就是分组滑动窗口技术,简单理解就是,每四个注意力层才进行一次完整的输入序列的注意力,其他的注意力层都只关注固定的滑动窗口内的 token 之间的关联。
注意力机制 #
注意力机制的优化思路有两种,保持 \(O(n^2)\) 的复杂度转而优化其他常数项,或者从机制上改进注意力使其只有 \(O(n)\) 的线性复杂度。前者在上下文不特别长(2M 以内)的时候非常有效果,比如 ChatGPT 中使用的局部滑动窗口注意力,另外也可以通过极致的系统工程来优化常数项,在这方面做得非常极致的一个框架就是 FlashAttention,能够达到普通 PyTorch 速度的 4 倍左右。
但如果我们想要处理更长的输入序列,就需要从 \(O(n^2)\) 这个角度下手了,我们需要将其优化为 \(O(n)\),核心的思路就是从标准平方注意力机制的公式入手:
$$ \text{Attn(Q,K,V)} = \text{softmax}(QK^T)V $$如果 softmax 函数能够被忽略的话,那么注意力机制天然就是线性的,下面给出的是批处理形式的表达式,可以方便地用于训练时:
$$ \text{Attn(Q,K,V)} = (QK^T)V = Q(K^TV) $$还有递推形式的表达式可以用于推理时,此时的表达式非常类似 RNN:
$$ \begin{matrix} S_{t} = S_{t-1} + k_{t}v_{t}^T \\ y_{t} = q_{t}^TS_{t} \end{matrix} $$在实际的模型中这种线性的注意力层确实是有使用的,比如 MiniMax-M1 模型就使用了 7 层线性注意力结合 1 层平方注意力的混合注意力形式,缓解了纯线性注意力召回率不佳的弊端和纯平方注意力开销太大的弊端。为了对线性注意力带来的召回率损失有一个更加直观的印象,这里引用一张字节对于混合线性注意力机制的调研论文中的结果图:
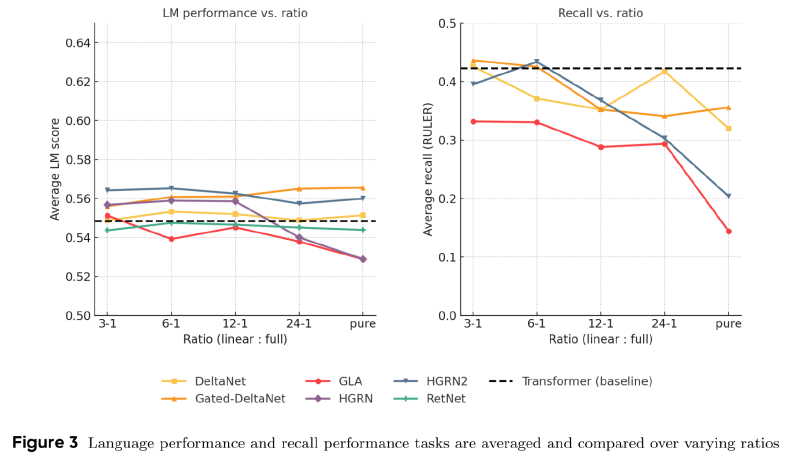
从右图中可以看出,纯线性注意力在召回率上会出现显著的下降。一个有意思的现象是左图中部分纯线性注意力模型语言能力表现竟然优于标准二次方注意力机制(这里的模型表现评分其实是综合了困惑度和基准测试的综合评分指标),这也说明了纯召回任务和实际的语言任务并非完全对齐,实际的语言任务对于精确召回的要求并不高。从右图中可以得出另一个更有实际意义的结论:按照 \(3:1\) 混合的线性注意力机制在召回率上可以达到与标准注意力机制持平的效果,这也是为什么后文提及的实际应用中常常使用 \(3:1\) 混合方案的依据。
在线性注意力的递推表示形式的基础上,叠加记忆衰退因子 \(\gamma_{t} = f(x_{t})\) 用于清理旧的记忆状态,输出补充上一个 \(v_{t}^TD\) 作为门控输出项(让部分信息可以避免状态压缩直接输出),这样就得到了 Mamba-2 的表达式。Mamba 系列可以说是线性注意力中非常出名的一个系列了,在 Nemotron-3 模型中使用 \(3:1\) 的形式与标准注意力进行混合,获得了比纯线性更优的性能。
$$ \begin{matrix} S_{t} = \gamma_{t} S_{t-1} + k_{t}v_{t}^T \\ y_{t} = q_{t}^TS_{t} + v_{t}^TD \end{matrix} $$在 Mamba-2 表达式的基础上对特定方向进行 Delta 修正,并对新的记忆项使用 \(\beta_{t} = f(x_{t})\) 进行门控输入这样就得到了门控 Delta 网络的表达形式:
$$ \begin{matrix} S_{t} = \gamma_{t} (I-\beta_{t}k_{t}k_{t}^T) S_{t-1} + \beta_{t}k_{t}v_{t}^T \\ y_{t} = q_{t}^TS_{t} \end{matrix} $$其中 \((I-\beta_{t}k_{t}k_{t}^T)\) 表示清除掉当前 \(k_{t}\) 相关的部分记忆,然后让新的记忆项 \(\beta_{t}k_{t}v_{t}^T\) 输入其中。这个方案最大规模的实践就是 Qwen-3.5 模型,但同样并非纯线性注意力而是使用 \(3:1\) 混合的形式来扬长避短。可以注意到的一个趋势就是:线性注意力机制逐步收敛到了类似 LSTM 系列的相关方案上了。
当然除了使用隐状态方案,还有稀疏激活的方案,具体的实践就是 DSA(DeepSeek Attention),使用轻量化的索引去计算得到最优的 Top-k 个需要的 token,这样能够控制 \(O(n^2)\) 的注意力机制成本可控。这种方案在 DeepSeek-v3.2 和 GLM-5 模型中都有使用,实际效果非常不错。
题外话
虽然跑分结果看上去很不错,但是实际使用过程中就会发现上下文约束遗忘的现象还是很严重,一般来说并不放心让 DeepSeek 的模型去干很复杂的工作,如果仔细审核的话能够发现很多上下文中提过的约束并没有很好地遵守。总之就是有些笨笨的🤔特别是和 Anthropic 的模型对比来看确实是有明显的差距
MoE #
混合专家架构(Mixture of Experts, MoE)是目前非常主流的一个架构方案,这个方案让更大规模的模型以成本可控的方式运行,既享受了参数规模扩大带来的性能收益又控制了推理成本,可以说是一举两得的方案。当然 MoE 架构并不是一开始就很流行,因为其架构和训练平衡比较麻烦,从某种程度上来说 MoE 并不是单纯的算法上的进步,其在 LLM 系统工程上的意义似乎更大一些。
MoE 可以作用在 FF 层,也可以作用在注意力层,但几乎所有的 MoE 都只作用在 FF 层,默认情况下 MoE 指的都是 FF 层的 MoE,下文也遵循这个惯例。
MoE 有几个关键的组件:路由函数,专家数量,训练目标;路由函数和专家数量非常容易理解,但训练目标一般而言有两层含义,一则是训练语言模型本身,二则是路由平衡,让不同的专家都得到充分的训练。
常见的路由函数包括 Top-k 和 Hash,还有使用 RL 去学习路由策略的方案,将路由平衡问题建模为线性分配问题的策略。其中使用最为广泛的就是 Top-k 策略其公式表达如下:
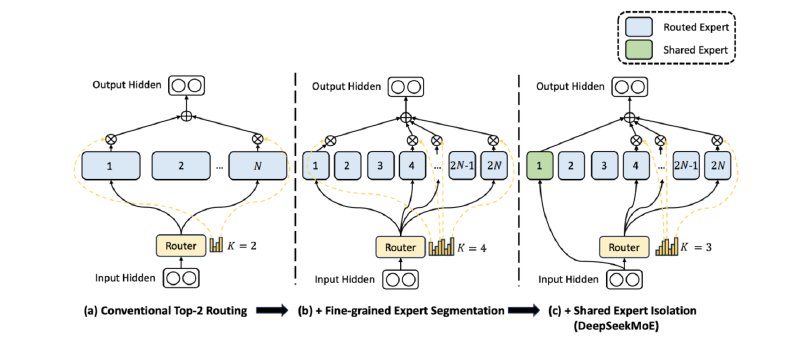
$$ h_t^l = \sum_{i=1}^{N} \left( g_{i,t}\operatorname{FFN}_i(u_t^l) \right) + u_t^l $$$$ g_{i,t} = \begin{cases} s_{i,t}, & s_{i,t}\in \operatorname{TopK} \left( \{s_{j,t}\mid 1\le j\le N\}, K \right),\\ 0, & \text{otherwise}, \end{cases} $$$$ s_{i,t} = \operatorname{Softmax}_i \left( (u_t^l)^T e_i^l \right) $$虽然这一堆花里胡哨的公式看着非常令人头大,但是翻译成人话就是:输入 \(u_{t}^l\) 先和每一个专家的键值 \(e_{i}^l\) 进行内积运算然后进行 softmax 归一化获得最终的匹配程度分布,然后在门控函数 \(g_{i,t}\) 中计算 Top-k 其余归零(这其实是一个批量计算的技巧,用特殊值避免了计算 \(h_{t}^l\) 的时候去做分支判断),然后就是正常的前馈计算流程,使用简单的求和对不同专家的输出进行聚合,然后再加上残差即可。
更进一步,可以对专家进行合适的分片并提取出公共的权重,这样可以让非共享专家的功能更加分化,从而实现更好的集成学习效果。这种方式就是广为使用的 DeepSeekMoE 方案。
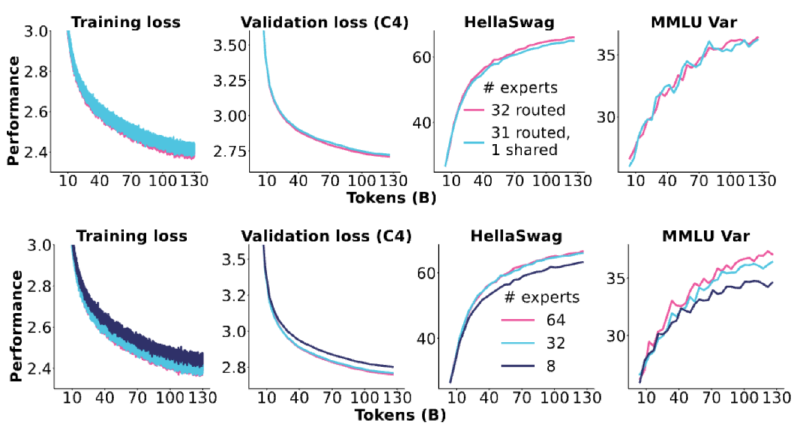
逻辑上来说,共享专家和其他非共享的专家对于模型表现都应该具有贡献,但是 OlMoE 的消融实验结果则表明,这种方式带来的性能增长来源于合理的非共享专家划分,而不是共享专家本身。
具体的专家切分比例如下面表格所示,同时从中也可以看出 DeepSeek-v1 确实是首次提出对专家模块进行再分片的模型。
| Model | Routed | Active | Shared | Fine-grained ratio |
|---|---|---|---|---|
| GShard | 2048 | 2 | 0 | - |
| Switch Transformer | 64 | 1 | 0 | - |
| ST-MOE | 64 | 2 | 0 | - |
| Mixtral | 8 | 2 | 0 | - |
| DBRX | 16 | 4 | 0 | - |
| Grok | 8 | 2 | 0 | - |
| DeepSeek v1 | 64 | 6 | 2 | 1/4 |
| Qwen 1.5 | 60 | 4 | 4 | 1/8 |
| DeepSeek v3 | 256 | 8 | 1 | 1/14 |
| OLMoE | 64 | 8 | 0 | 1/8 |
| MiniMax | 32 | 2 | 0 | ~1/4 |
| Llama 4 (maverick) | 128 | 1 | 1 | 1/2 |
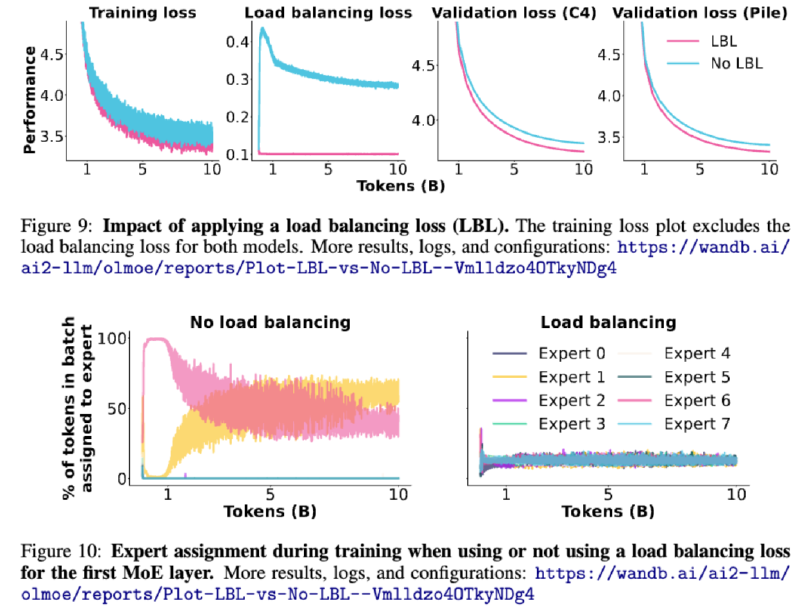
最后就是 MoE 的训练方案部分了,为什么 MoE 的训练比较困难,最大的原因就是路由函数本身并不具备可微的性质并且训练过程往往不够稳定。一些早期的思路尝试将路由策略建模为 RL 过程,但没有明显的效果提升;使用带有噪声的 Top-k 采样,虽然能够提高训练稳定性,但是略微降低了模型的性能表现;目前最有效果的方案就是采用类似正则化的方法,在损失函数中引入启发式的路由平衡正则项:
$$ \text{loss} = \alpha \cdot N \cdot \sum_{i=1}^{N} f_i \cdot P_i $$$$ f_i = \frac{1}{T} \sum_{x \in \mathcal{B}} \mathbb{1}\{\operatorname{argmax} p(x) = i\} $$$$ P_i = \frac{1}{T} \sum_{x \in \mathcal{B}} p_i(x) $$其中 \(f_{i}\) 表示专家 \(e_{i}\) 实际接收 Token 的比例,\(P_{i}\) 表示路由函数意向分配给 \(e_{i}\) 的期望概率。这种形式利用了不可导的 \(f_{i}\) 来引导可导的 \(P_{i}\) 从而对不平衡的分配意向进行梯度惩罚:
$$ \frac{\partial \text{loss}}{\partial p_i(x)} = \frac{\alpha N}{T^2} \sum_{x \in \mathcal{B}} \mathbb{1}_{\operatorname{argmax} p(x) = i} $$最终实验的结果表明,这种启发式的方案效果好像真的还不错,很好地平衡了不同专家的负载。当然,标准的 DeepSeekMoE 还加上了设备负载平衡的正则项。
后续的 DeepSeekMoE-v2 又在 DeepSeekMoE 的基础上增加了 Top-M 的设备路由机制和设备之间的通信开销的正则项,用于降低设备之间的通信开销。实话实说,这个正则项实在是有点太多了,虽然有效但不够优雅。所以 DeepSeekMoE-v3 尝试通过增加偏置项来抹掉这些正则项,虽然最终并没有完全抹掉就是了。
当然 MoE 的训练稳定和微调都与标准的密集 FF 模块有所区别,具体来说就是更差了。训练不稳定是由于路由函数中引入的 softmax 函数(十处训练不稳定九处都是 softmax🤣),这个问题可以使用训练稳定性小节提到的 Z-loss 方法进行缓解。而微调部分的问题则是 MoE 模型在小规模的数据上进行微调相比于标准方案更容易过拟合。DeepSeek 对此的解决方案是:用大规模的数据进行微调。
整体上来说 MoE 相关的部分都有很浓烈的工程色彩,这也是为什么我在本节开头就说明了:MoE 在系统工程上的意义似乎更大一些。本质上来说 MoE 是用极具工程色彩的方案拉高了规模定律的适用范围,使得我们能够继续简单地从模型的规模中榨取性能。
系统工程 #
这部分内容的核心就是了解现代 GPU 的大致工作原理以及如何将这些原理用于模型架构的选择以及算法的改进。对于模型架构方面,一个比较著名的例子就是 NanoGPT Speedrun (一个竞速项目),最大的速度提升是将模型的词表扩大为最近的 64 的整数倍。
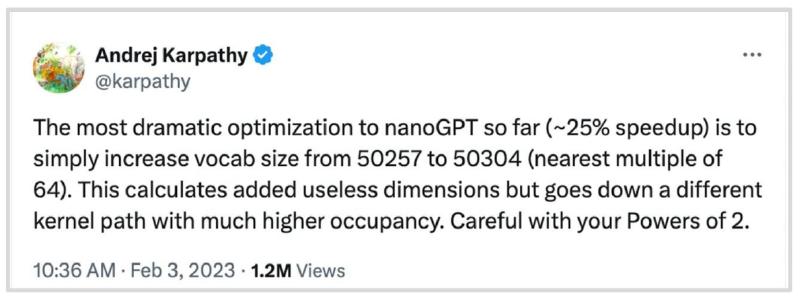
而算法设计上的例子就是 FlashAttention,不用多说,这个方法的提升甚至都是按照整数倍来计量的而不是百分比。
GPU 架构 #
GPU 的内部架构与调度机制,可以清晰地拆解为"编程与存储视角"和"硬件与调度视角"两个正交维度,其中编程与存储视角如下
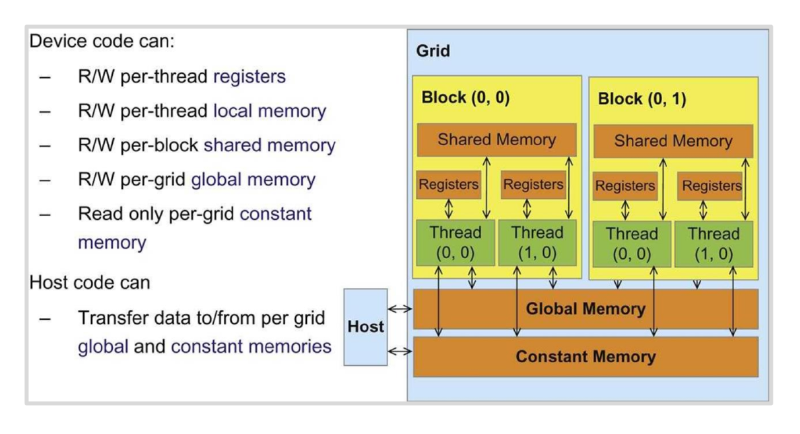
- Thread:并行计算的实际单元,所有 Threads 执行相同的指令但作用在不同的输入数据上
- Block:一组 Threads,重点是一个 Block 中的 Threads 可以通过共享内存通信
- Grid:一组 Block 并配备共享的全局内存和静态内存进行通信
- Host:主机端 CPU 及其内存,数据在 Host 与 GPU 显存之间通过 PCIe 传输,由于带宽和延迟受限,跨 Host 相关的交互与数据搬运是非常昂贵的
而从硬件与调度视角来看则有下面这些概念:
- SM(Streaming Multiprocessor):GPU 的物理大核心,拥有独立的 Warp 调度器、寄存器堆、共享内存和计算单元,负责承接并执行 Block
- Warp:微观层面的硬件最小执行单元,通常固定为 32 个 Threads。它与 Block 的主要区别在于:Block 是开发者根据逻辑定义的任务块(大小与维度可变),但硬件在实际调度时会把它切片划分为若干个 Warp,同一个 Warp 内的 32 个线程步调一致地接收调度器指令;Warp 存在的核心意义是通过快速上下文切换来隐藏高访存延时以提高整体吞吐(例如当 Warp 0 读内存卡顿等待时,调度器能零开销立刻切换给 Warp 1 发射计算指令)
- Wave:宏观层面的整卡调度批次,指整块 GPU 的所有 SM 一次性能够同时并发容纳并执行的最大 Block 总量,GPU 只能以整波为单位推进计算任务
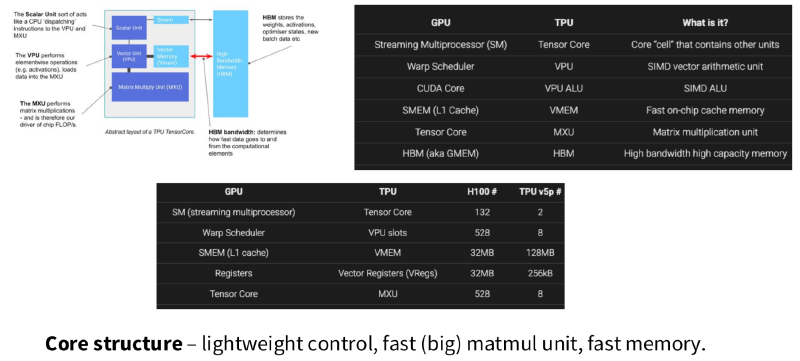
直观上来说,GPU 的架构与传统的 CPU 架构非常类似,有计算机体系结构基础的同志应该能够轻松理解,其多级缓存结构与 CPU 的多级缓存几乎一致。另外,TPU 的设计架构与 GPU 其实很类似,TPU 中的概念在 GPU 中几乎都有对等的概念。最大的区别就是:更轻量化的控制器,更大的矩阵乘法单元,更快的 L1 Cache(GPU 中的 Share Memory,TPU 中的 Vector Memory)
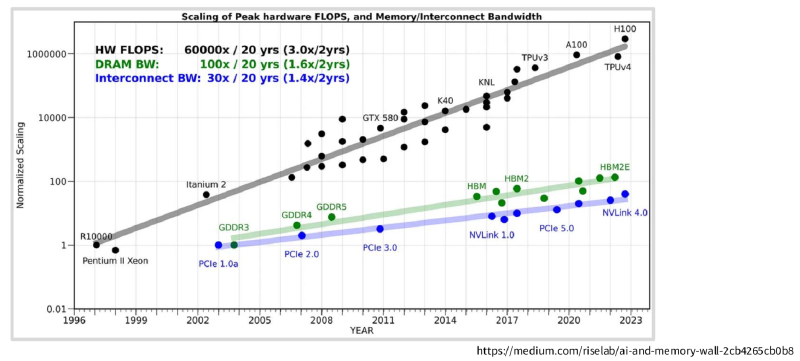
GPU 架构中的不同部分的迭代速度是不同的,计算能力的迭代速度远高于缓存的迭代速度,如下图所示。这也是为什么目前系统工程的优化大部分都集中于缓存优化,因为计算能力远高于缓存的加载速度:减少 1 次访存可以带来 10000 次的吞吐量提升(甚至更高)
优化技巧 #
分支控制 #
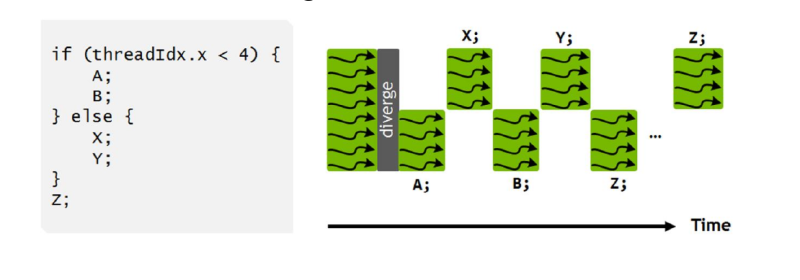
简而言之:使用 mask 替代分支指令(if-else);这么做的主要原因是 Thread 的一个核心约束:每一个 Thread 都需要执行相同的指令,如果有分支判断的话不同的输入数据可能选择不同的分支,这是一个需要解决的矛盾。当然,硬件层面的解决方法也非常直接:不同的分支都会被计算一遍,最后再选择性丢弃一部分计算结果
低精度计算 #
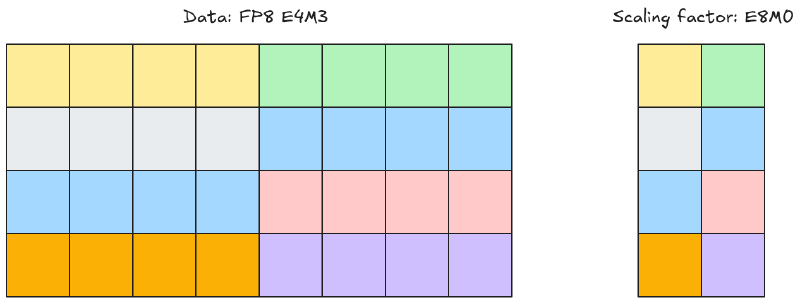
很直白,降低参与计算的数据精度,换取数据吞吐。为了用如此低的比特数来训练模型,总是需要一些技巧的。目前主流的思路是一组低精度数据配上一个缩放因子,代表就是 MXFP8 格式的数据。这种方式有一个需要处理的问题:转置如何计算?数据是按照行来分块并配备缩放参数的,转置之后行变成了列,与原有的数据结构不一致了。这个问题其实很难用优雅的方式解决,在实际训练的过程中,是直接拷贝一份数据专门用于转置操作。
还有一种思路在 CS336 课程中没有提及,可能是这个方法比较复杂并且目前没有生产级的大模型使用了这种方法,论文链接附上,该论文在 8B 规模的 LLM 训练中实现了全流程 FP4 精度。在此之前,NVIDIA 其实已经有相关的方案能够使用 FP4 精度来训练模型,但没有开源出来。于是该论文根据 NVIDIA 公开的技术博客使用 BF16 模拟了 FP4 的训练行为,据说能够模拟模型的精度,训练损失和收敛性,算是非常严谨的对比实验了。
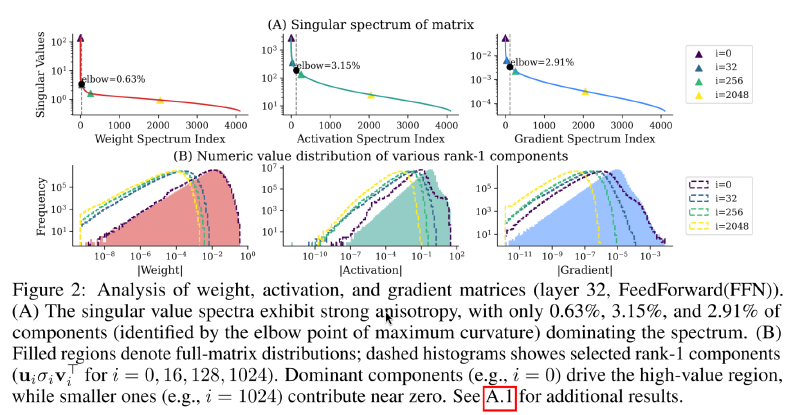
具体而言,这篇研究想要解决的问题是:深度学习参数的数值分布较为广泛,直接使用 Scaling factor 方案作用于原始矩阵数值会导致小数值被大数值抹平(典型的量化损耗),因为大的动态范围会让量化精度网格变得稀疏,小数据会挤在很小的一个接近 0 的范围内,很容易就被量化为 0 了。一个直觉是大数值和小数值应该分开表示,于是研究使用 SVD 的方法对矩阵数值进行了分解,其中 \(\sigma_{i}\) 就是从大到小排序后的奇异值:
$$ M = \sum_{i=1}^{r} \sigma_i \cdot (u_i v_i^T) $$实验结果如下所示,大约 3% 的奇异值主导了数值的分布上界(大约相差一两个数量级),如果分离这些大奇异值的话,剩余的残差矩阵的数值就能够更均匀地分布在量化网格上;而分离出来的主导分量则天然可以被一个缩放参数和两个数值相对平坦的奇异向量表示,很适合 FP4 量化
值得一提的是 SVD 量化这个思路并非首创,在上面这篇研究之前就已经有一个类似的方案了:SVDQuant,虽然都是使用 SVD 但这篇研究感觉没做干净,高精度矩阵还是在搬来搬去并且还需要处理稀疏矩阵乘法等难题,而上面这篇研究则很漂亮地放进了 Scaling factor 和奇异向量里面。
算子混合 #
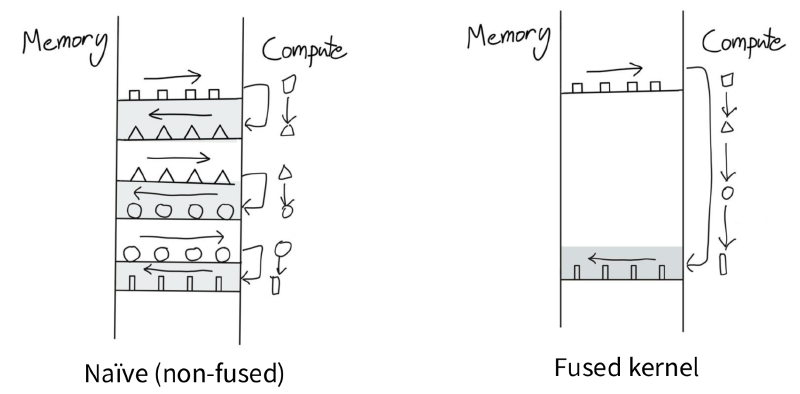
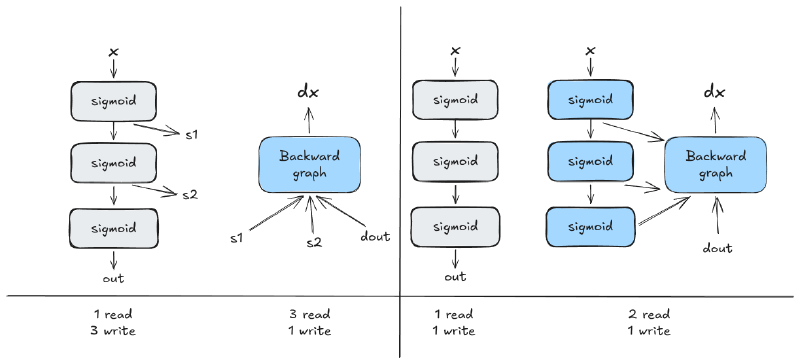
将不同的算子融合为一个整体,避免在 HBM 中反复进行读写,降低访存次数,这也是 FlashAttention 中的一个核心操作。下面这个插图能够非常直观地看出其动机:一次数据读取之后尽可能多地计算,避免中途写回。
重计算 #
字面意思,中间变量不写缓存,需要的时候重新通过输入计算一遍。以下面的这个计算为例,能够将 8 次访存变为 5 次。
批量访存 #
这个技巧涉及更加复杂的底层细节,DRAM (global memory) 的读取方式是并发式的,其工作原理就决定了一整行的数据都需要进入"预备状态"然后才能够从中片选出你需要的数据。换言之,一整行数据加载的成本已经付出了,我们能做的只是尽量从中片选出尽量多的数据来摊薄成本。
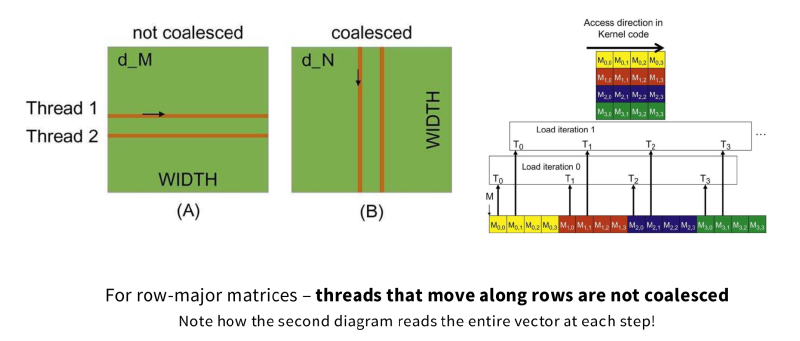
举个例子,一个行优先矩阵如果让 Thread 工作于不同的行索引,就会产生不连续的访存;但是如果让 Thread 工作在同一个行索引,这样就能够利用 DRAM 整行加载的特性,一次性满足大量 Thread 的数据需求。
分块 #
与算子混合的目标一致,都是降低访存次数,或者说减少不必要的访存,让一次数据读取对应尽量多的计算。
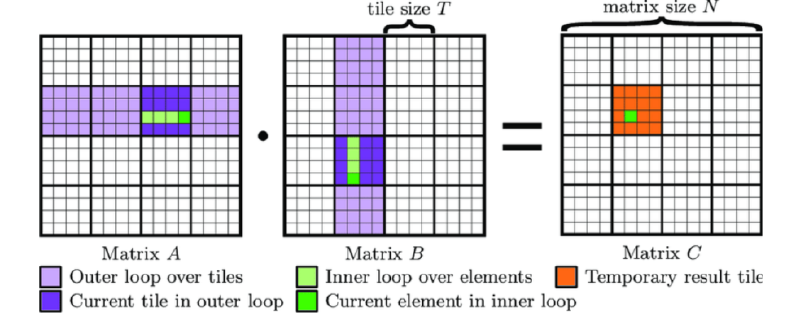
如上所示,如果不进行分块的话,那么每一个输入都需要从全局缓存读取 N 次,进行分块之后每一个输入只需要从全局缓存中读取 N/T 次,然后在 Block 中的共享缓存再读取 T 次即可,而共享缓存的读取速度是很高的,几乎将全局缓存的访问变为了原来的 \(\frac{1}{T}\),是一个非常强悍的优化了。
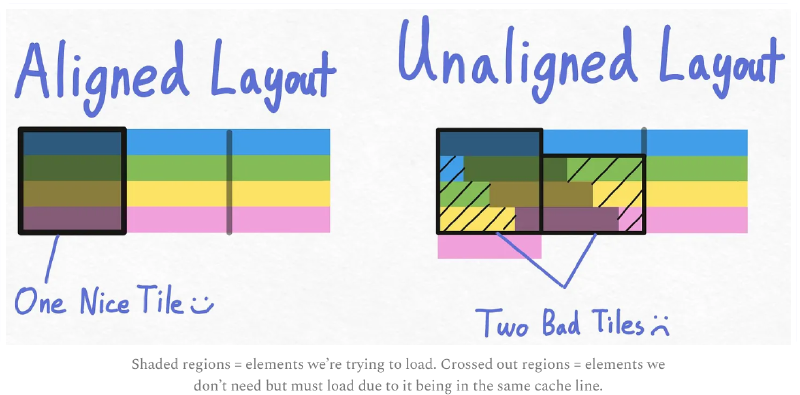
值得一提的是,这个技巧的效果与参与运算的矩阵形状有很大的关系,如果矩阵的形状不合适则会产生很大的损耗。一则是不良分块,某些分块中几乎没有数据纯粹空转,如下图所示。

二则是对齐,如果矩阵的形状合适,那么一次 Tiling 读取的数据就能够非常高效地利用 DRAM 的并发读取特性;如果形状不合适,那么对于吞吐的影响也是巨大的。
数据图品鉴 #
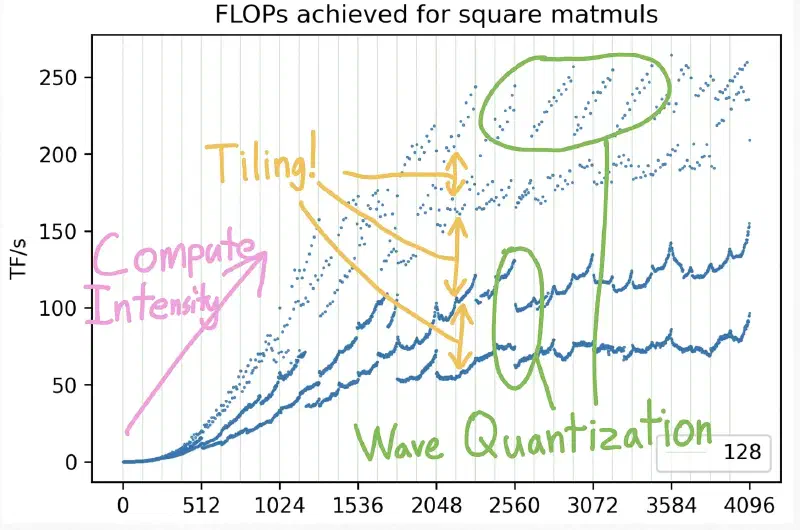
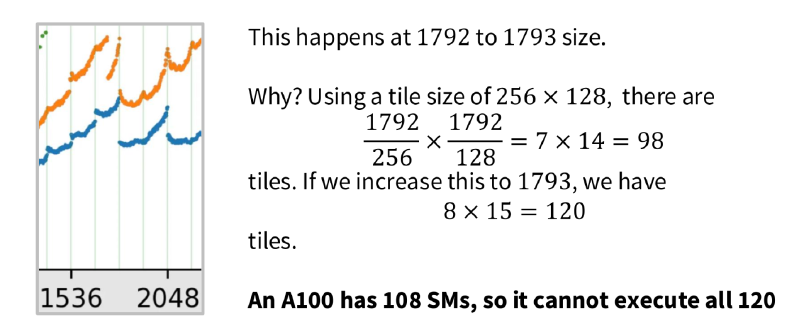
了解了先前所有的优化技巧之后,这幅图中诡异的现象就能够被解释了:首先大体上的趋势是算数强度随着矩阵变大而增长;非常明显的断点则是由于不良矩阵形状造成的(具体原因见分块小节),一个对齐的矩阵形状能够带来接近一半的吞吐提升;最后图线中的神秘周期性断点,是由于 GPU 按整波推进过程中产生的,简而言之,当矩阵的形状达到某一个特定的临界之后,会突然产生一个 Wave 无法完成的计算任务,从而被强制向上舍入量化为整数 Wave,但实际上最后一个 Wave 的负载是不够的。这也是这个现象叫作波次量化(Wave Quantization)的原因
工程细节 #
在上一节内容的浸泡之下,你可能会觉得系统工程和之前的架构设计还有点像哈,只是换了一个领域的知识。但实际工作中,这一节的内容远比你想象中更加琐碎,这一节就是专门的工程碎碎念😅
基准测试 #
在进行任何优化之前,必须要做的一个动作就是搭建一个基准测试框架来量化你的系统。而这里的基准测试框架基本上指的就是:对不同计算过程的时间进行准确测量。
具体而言,在基础部分我们获得了一个精美的 Transformer 模型。我们首先可以去测量一些粗糙的部分:前向、后向、参数更新。这三个大阶段是比较容易测量的,只需要将训练过程拷贝一份然后简化其中的逻辑,在各个阶段打上断点即可。需要注意的只有一些问题:
- 使用
timeit.default_timer()而非time.time(),前者能够拿到系统最高级的时钟从而获得更准确的计时(现代深度学习计算硬件的速度非常快,因此需要更精确的测量) - 使用
torch.cuda.synchronize()去排空 GPU 中剩余的计算。CPU 对 GPU 的调用的异步的,计算任务发出后 CPU 会立即进行下一条任务,因此需要阻塞等待 GPU 完成任务之后再测量时间差才是准确的
当然,这么粗糙的测量对于系统工程层面来说是不够的,因此就需要使用 NVIDIA 官方提供的一些工具来精确测量某一个阶段中的具体的内核耗时,也就是 Nsight Systems,PyTorch 对这个也是有支持的,也就是 torch.cuda.nvtx 这个子模块中的相关接口。使用方式不算难,但是工程实现上有一个非常头疼的问题:计时代码注入。理想中的代码注入需要有一些性质:
- 简单明了,可读性高
- 使用方便,能够简单地控制某一处的测量是否启用
- 不污染原本的训练代码
CS336 中默认使用的是"猴子补丁"方案,具体来说就是对 Python 的模块导入系统下手,将别的模块中调用的函数直接劫持成自己加了注解的函数。看上去还挺合理的对吧,但是说实话这个操作是需要一些微妙手法的,比如劫持的顺序、目标模块原本的导入方式等等,一不小心就会劫持失败。而且该方案没法劫持反向传播过程,因为反向传播过程被完全封装到了 PyTorch 之中,猴子补丁是注入不进去的。
import cs336_basics.layers.multihead_self_attention as _mha # this should be a module type!

from cs336_systems.utils import annotated_scaled_dot_product_attention

# monkey patch
_mha.scaled_dot_product_attention = annotated_scaled_dot_product_attention  # type: ignore
工程的琐碎之处就在此淋漓尽致地体现了出来,如果你认为猴子补丁方案很丑陋,你想要找到一个更优雅的解决方案。那么恭喜,你将会像直接中了无量空处一样接收到一堆神秘的名词,一通对比之后你会发现猴子补丁方案真是太简洁优雅了,有效得恰到好处😅
总而言之,在初次接触这些东西的时候难免会手忙脚乱,但应对混乱的有效办法就是不断试错,运行一个命令,理解其输出(追问 AI),然后纠正自己的理解偏差。你可能会问,现在这个 AI 时代这些细节还有了解的必要吗?我的观点是:你只需要记住你印象最深的就行了,比如,nsys 中会维护一条 GPU 事件流,nvtx 投影的作用就是将 CPU 标记的时间段投影到 GPU 事件流中从而圈定出目标代码背后真正运行了哪些 GPU 操作。
这里放一些实验结果吧,下面这张图就是在不同大小的模型上运行不同长度的输入的最耗时内核统计表,内核名称经过了美化,保留了其核心含义。
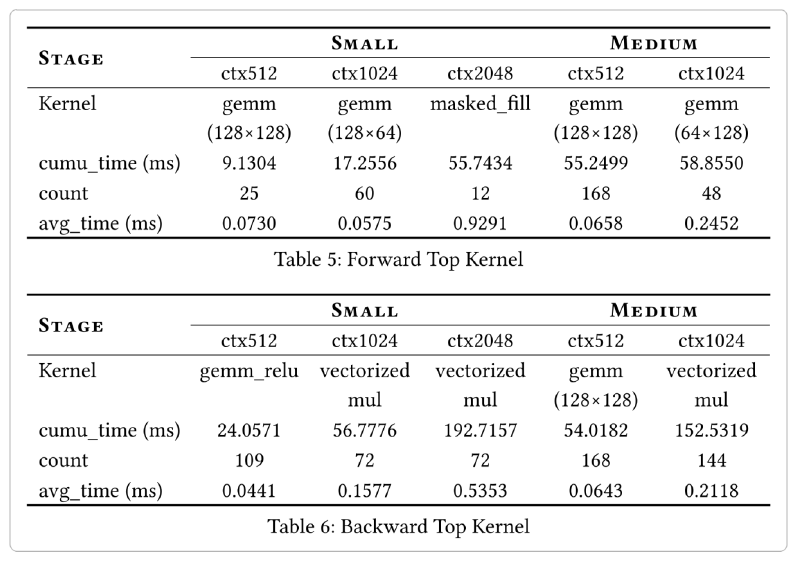
前向传播大部分情况下最耗时的 kernel 是 gemm 也就是广义矩阵乘法内核(\(D = \alpha AB + \beta C\));在上下文长度达到 2048 的时候出现了一个特例,最耗时的 kernel 变为了 masked_fill 也就是掩码覆盖步骤,这个转变说明了长上下文的瓶颈是内存而非计算;后向传播过程中大部分耗时集中在 vectorized_mul 也就是逐元素乘法内核上,这也是反向传播过程中的一个特点,那就是存在大量的逐元素操作(逐元素加,逐元素取指数等等都占据了不小的比例)并且这种逐元素计算开销很大;另一个值得一提的那就是 gemm 内核的形状,其并非是我们送入的张量的形状,这里其实就是 GPU 自动分块的具体表现。
关于冷启动问题,在测时间的时候一般需要充分的冷启动以及多次测量取平均值,在测量内存的时候则不需要那么多的冷启动和测量,一般来说只需要一次冷启动和一次测量即可
猜你想问:既然是测量内存,不要冷启动不行吗?反正在第一次反向传播的时候会到达峰值。实际上这个说法非常微妙,实际上可以但要明确这么做会发生什么。因为 PyTorch 的特性,优化器的参数会在第一次 optimizer.step() 的时候才分配,如果你的测量步只有一步,那么在优化器内存加载之前激活的峰值就会过去,导致你测量得到的并不是常态的内存峰值,而是激活峰值和优化器峰值两者之间的更大值。那如果你的测量步有两步及以上呢?那本质上就是将冷启动搬运到了测量步,因此内存测量时冷启动是必要的!
Triton Kernel #
在学习之前,Triton kernel 是一个非常神秘的东西,用魔法般的力量让你的模型跑的飞快。但实际上,在接触了一些编程训练之后你就会意识到,真正的魔法在于算法设计而不是 Triton kernel,也就是下一节 FlashAttention 部分会记录的内容。并且这里主要记录的是一种被称为 Block pointer 的编程思路,是一种较新并且更容易理解的方案。
在正式理解 Block pointer 之前,有一个非常重要的心智模型需要理解。在一个 kernel 内部我们处理的总是一个二维的运算,并且总是分块进行的,因为 GPU 的 SRAM 并没有那么大,只能够算一块再加载下一块数据。猜你想问,那高维的张量计算怎么办?有两种思路,一种就是对维度进行展平操作,计算完成后再重新拼接回去;另一种是在启动内核的时候使用 Triton 的网格语法,但 Triton 的网格最多只支持三维,也就是说更多的维度只能够使用展平操作消化后再送进内核。
这里的网格可以理解为 GPU 的并行处理维度,每一个网格之中都会有一个线程来处理你的任务并且线程之间应当是解耦的,每一个线程内部会去 for 循环加载最后这个维度的不同分块然后进行计算。就这个简单的二维场景而言,网格就可以是行方向或者是列方向,选定网格方向之后,你就想象有一批割草机按照这个方向填充,然后沿着另一个方向一块一块地收割 (是的没错,就是植物大战僵尸里的小推车😄)
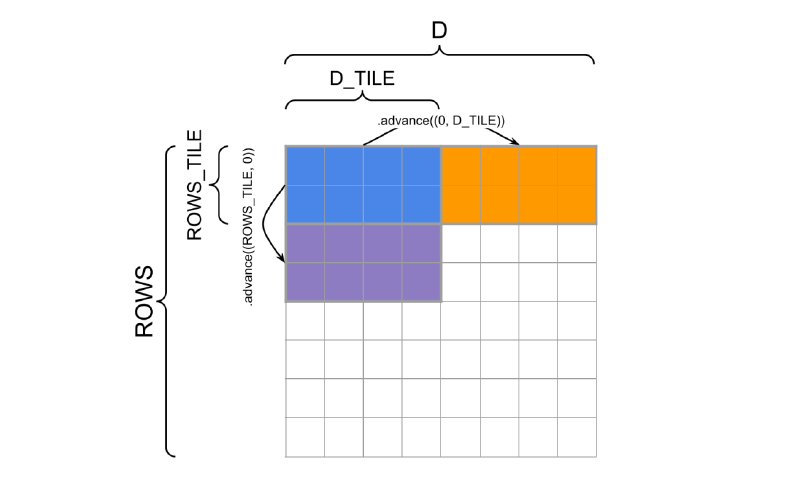
上面就是 Triton 内核编程的核心计算部分了,非常清晰明了,和普通的 PyTorch 编程没有太大的区别,只是加了一些分块的技巧。所以真正比较耗费心神的其实是数据加载:
- 数据的逻辑存储和物理存储是解耦的,你需要十分小心地去挪动指针
- 为了计算效率,你需要根据物理存储方式的不同去调整计算顺序从而利用批量访存技巧来加速
- 当实际矩阵的大小不能够被分块大小整除的时候,我们一般会向上取整保证所有数据都被处理,但这就会带来越界访问的问题,我们需要在这时候对数据进行填充
- 数据写回的时候同样需要检查越界访问的问题
这些问题在没有 Block pointer 抽象的时候是非常繁琐并且极其容易出错的,并且你的代码中会充斥着各种边界情况,你的主体计算逻辑会支离破碎,可读性极差。有了 Block pointer 之后,这些复杂的逻辑就能够封装到 block 内部了,下面就是几个 Block pointer:
x_block_ptr = tl.make_block_ptr(
    x_ptr,
    shape=(NUM_ROWS, D),
    strides=(x_stride_row, x_stride_dim),
    offsets=(row_tile_idx * ROWS_TILE_SIZE, 0),  # parallel on rows, so only the affected set offsets
    block_shape=(ROWS_TILE_SIZE, D_TILE_SIZE),
    order=(1, 0),
)

weight_block_ptr = tl.make_block_ptr(
    weight_ptr,
    shape=(D,),
    strides=(weight_stride_dim,),
    offsets=(0,),
    block_shape=(D_TILE_SIZE,),
    order=(0,),
)

output_block_ptr = tl.make_block_ptr(
    output_ptr,
    shape=(NUM_ROWS,),
    strides=(output_stride_row,),
    offsets=(row_tile_idx * ROWS_TILE_SIZE,),  # row affected
    block_shape=(ROWS_TILE_SIZE,),
    order=(0,),
)
第一个 block 就是典型的并行处理维度的 block,需要在构造的时候就指定 offsets 参数,第二个 block 则不需要,因为所有并行的线程都需要从同一个开始位置读取数据,第三个 block 就是计算结果需要写回的地方,不同的线程需要写到不同的位置,因此也需要设置偏移量。
然后其他参数需要关注的就是 strides 和 order 这两个,前者表示不同维度逻辑上相邻的数据在物理存储上相距多少字节(也就是步长);后者其实就是按照步长排序后的维度索引,PyTorch 是行优先排布的,所以步长最小的维度在更靠后的索引。
好的,所有复杂的情况声明都已经填充好了,我们在核心的计算循环中就可以极大地简化逻辑了:
output = tl.zeros((ROWS_TILE_SIZE,), dtype=tl.float32)  # row allocator
for _ in range(tl.cdiv(D, D_TILE_SIZE)):
    row = tl.load(x_block_ptr, boundary_check=(0, 1), padding_option="zero")  # (ROW_TILE_SIZE, D_TILE_SIZE)
    weight = tl.load(weight_block_ptr, boundary_check=(0,), padding_option="zero")  # (D_TILE_SIZE)
    output += tl.sum(row * weight[None, :], axis=1)

    x_block_ptr = x_block_ptr.advance((0, D_TILE_SIZE))
    weight_block_ptr = weight_block_ptr.advance((D_TILE_SIZE,))

tl.store(output_block_ptr, output, boundary_check=(0,))
说人话就是:先将分块数据加载到 SRAM 上,加载的时候去检查是否越界,如果越界就自动进行零填充,然后执行计算并将计算结果累加到 SRAM 上的另一个临时变量上,这个分块计算完成后就前进到下一个分块上。所有线程计算完成后一次性将临时变量收集好的计算结果写回 HBM 里面。
说明
第一次上手肯定是没那么清晰的,但理解之后就稍微好一些。虽然但是,内核编程确实是非常繁琐的😵即便是有 Block pointer 抽象简化。并且在学完这个章节之后你会意识到,内核编程不是目的而是手段,真正有意思的在于你如何解耦数据之间的依赖从而让并行处理成为可能
FlashAttention #
天才般的算法让数据解耦,同时也让我的大脑旋转😵💫😵
在编写算法之前我们需要分析目前的算法有什么问题,而分析算法需要的前置知识就是矩阵求导。强烈推荐去看看这两篇知乎文章:矩阵求导术(上) 和矩阵求导术(下);非常清爽的文章,补足了高数中几乎没有涉及的部分,并且避免了去啃大部头的矩阵分析书籍。
然后这里就不去讨论具体细节了,就放两张算法伪代码图片。
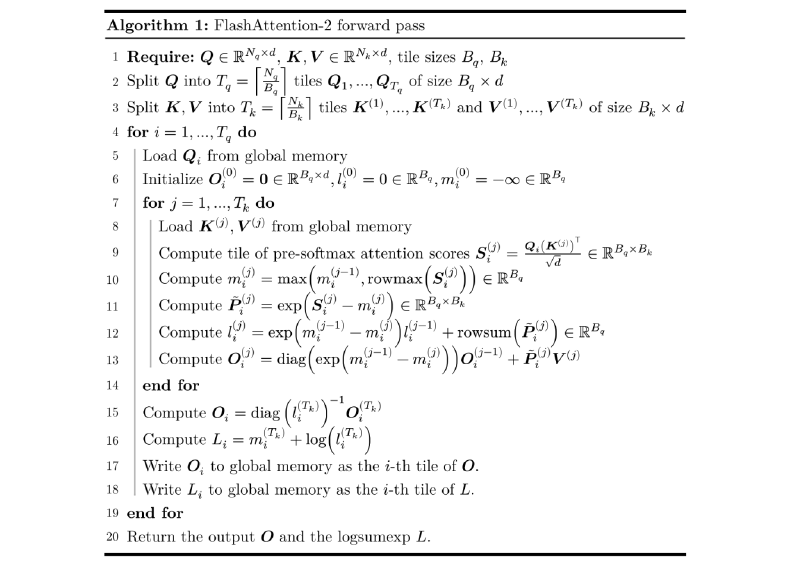
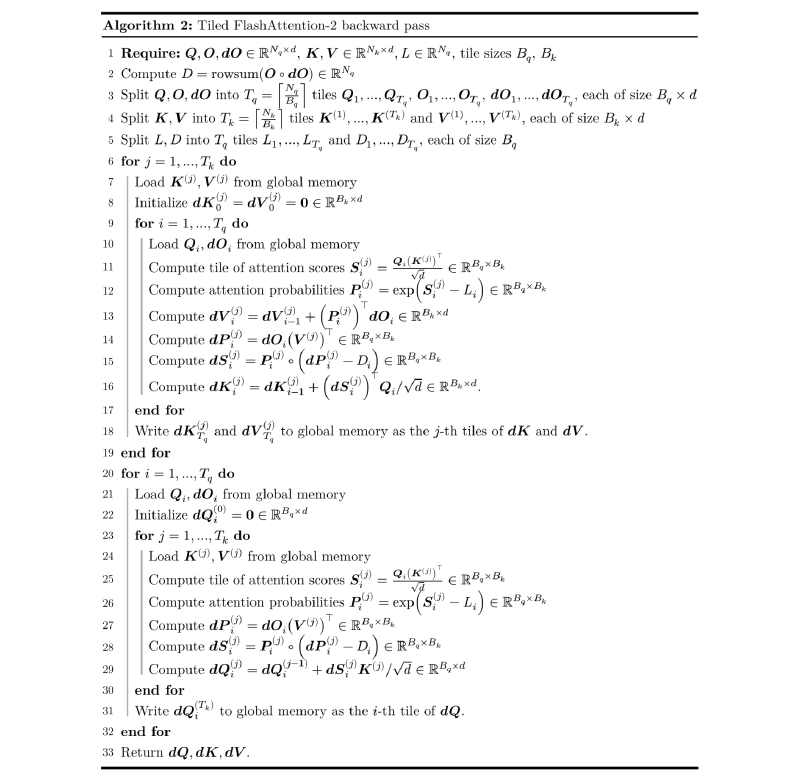
Flash Attention 的功绩自不必多说,实现了 \(O(N)\) 访存的注意力算法,极大地降低了整体计算耗时。但最值得关注的其实是前向传播过程中的"在线 softmax"算法,如何从直观上理解这个算法的可行性?
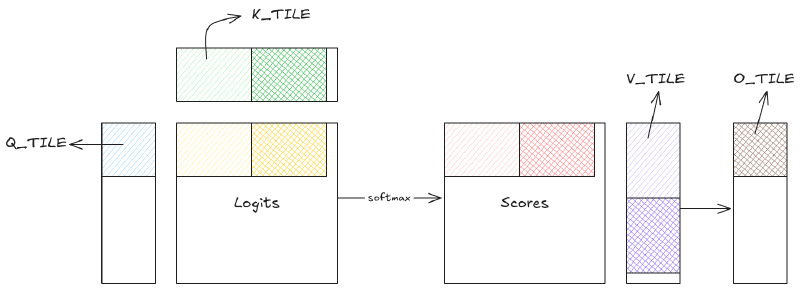
在线 softmax 的核心就是使用当前收集到的最新数据去修正先前的结果,一个比较困惑的点在于:我当前这个分块已经计算完毕了,怎么还能够去修正之前的结果呢?
事实上 score 的确是没法修正了,但最后我们要的也不是 score 而是最终的输出 \(O\) 矩阵。如图所示,可以发现,score 和 \(V\) 的矩阵乘法在这里起到了一个收集器的作用,让不同 \(K\) 分块的计算能够作用到同一个 \(O\) 分块上面去。我认为这才是在线计算能够进行的前提。
正因如此,我感觉这种操作被称为"在线 softmax"不太准确,感觉应该叫作"在线分块注意力"更准确。因为单纯的 softmax 就不能被在线计算,或者说在单纯的 softmax 计算中,后面的分块没法去修正前一个分块的计算结果🤔
分布式训练 #
为什么我们需要进行分布式训练?第一种情况,假设我们拥有一个算力中心,我们需要充分压榨这些算力卡避免资源浪费;第二种情况,我们有一个超大的模型,在一块 GPU 甚至、一台柜机甚至一个算力中心上都放不下,这个时候我们就不得不进行分布式训练了。
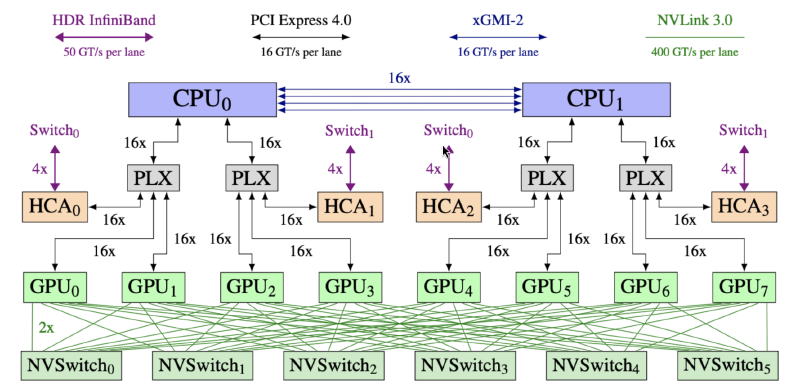
如图所示,这是常见的 GPU 集群的拓扑连接方式。当然 TPU 集群有别的连接方式 (一般来说是环形网状连接),但随着 MoE 逐渐成为默认选项,这种树形的拓扑连接逐渐成为主流。
说明
为什么不将所有 GPU 一对一连接?这样做通信开销当然是最低的,但是成本非常高昂因为你的接线数量将随着 GPU 数量平方增长,并且非常不灵活因为每增加一块新的 GPU 你就需要去调整原有的所有 GPU 的连接
基本操作 #
在构建复杂的数据并行操作之前,我们首先定义一些基础的数据通信操作,如下图所示。
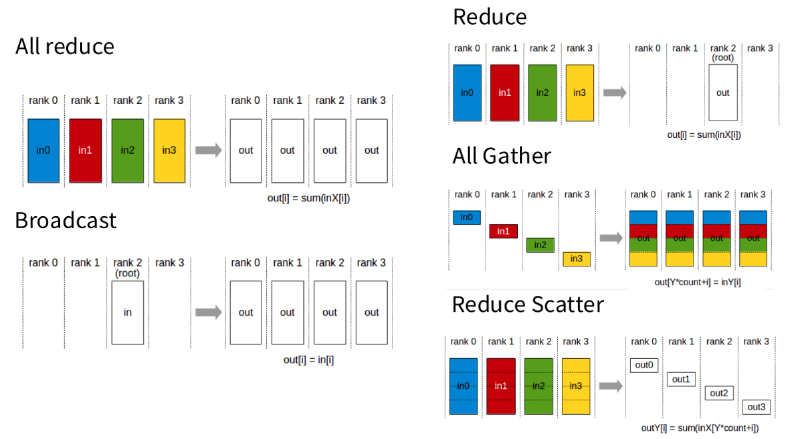
其中需要特别关注的是 All-reudce 操作,如果操作不当这个操作需要的通信开销是非常高昂的,比如一个非常直接的操作方式就是让各个 rank 之间交换全部的数据然后本地计算 reduce,整体通信开销为 \(3 \times 4=12\)。一个更加高效的做法是将 All-reudce 视作 Reduce-scatter 和 All-gather 的结合,整体通信开销为 \(4 \times\left( \frac{3}{4} + \frac{3}{4} \right)=6\)
补充
将一个大的操作切分还有另一个好处:可以利用计算和通信的重叠,更进一步减少等效的通信开销
数据并行 #
最单纯和数据并行非常容易理解,我们可以将批处理维度进行划分,每一块 GPU 都分配一部分,前向传播没有变化,然后在反向传播的时候进行一次 All-reduce 操作将其他 GPU 得到的梯度同步一下就可以了。但这么做的弊端也非常明显,每一块 GPU 都需要持有完整的权重、梯度和优化器状态。
ZeRO 提出了一个解决这个问题的非常优雅的方案,总共分为三个阶段,如图所示。之所以将 ZeRO 称为优雅是因为这个方案几乎是完全免费的,和传统方案相比几乎不会产生太多的通信开销。
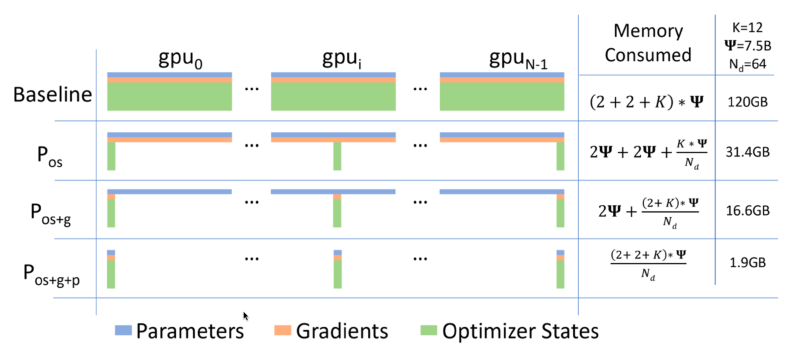
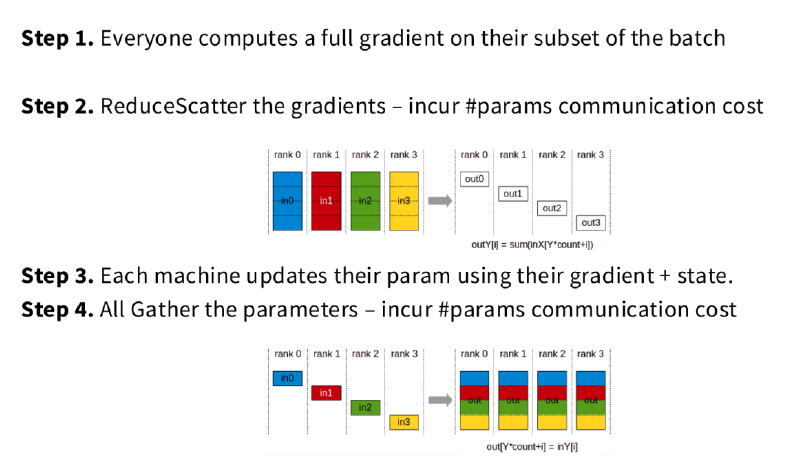
第一阶段,将优化器状态切分,让不同的 GPU 负责不同层的模型参数。这一步的实现其实就是 Reduce-scatter + All-gather;具体而言,让各个 GPU 卡在自己的部分批次上计算全量参数的梯度,然后分配到其他 GPU 上执行参数更新后再从其他 GPU 收集其他更新完成的参数。这一步显然是没有开销的,只是在原本的 All-reduce 操作之上插入了一步参数更新操作,但这一步操作可以让我们省掉绝大部分的冗余内存。
第二阶段,将梯度也进行切分。与阶段一对比来看,阶段一首先需要完整遍历计算图去计算所有参数的梯度,然后在进行数据交换;而阶段二则是在遍历计算图的时候就执行数据交换,然后立即释放自己不需要的梯度。非常容易理解,这一步也没有任何的成本,并且梯度对应的内存开销被平摊了。
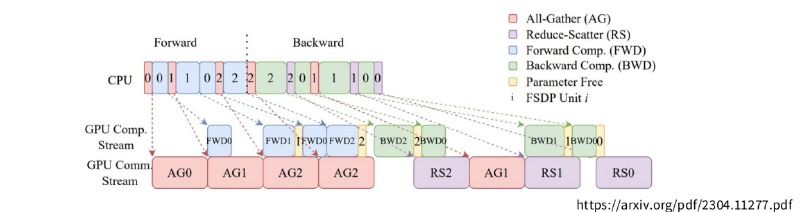
第三阶段,将权重也切分。核心思想就是不同的 GPU 持有不同的模型参数,当前计算需要别的 GPU 持有的权重时就进行通信实施获取参数,使用完成后立即释放。非常匪夷所思的是,即便到了这一步也可以做到近乎没有通信开销。这一步的技巧其实就是将通信开销和计算开销重叠,让计算开销去掩盖通信开销,如图所示。如果你的计算非常耗时(大矩阵乘法)并且 GPU 之间使用高速介质进行连接,这个技巧能够让权重的切分也几乎零成本。
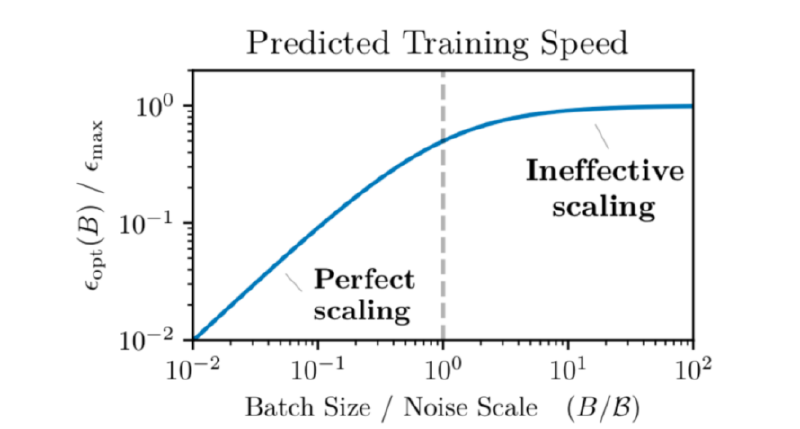
当然,ZeRO 并非无所不能,其隐含要求:GPU 数量不能够超过批处理大小。看上去没什么问题,大不了增加批处理大小嘛。然而实际上,GPU 的数量没有上限,但批处理大小是有上限的,超过这个临界之后模型的训练速度就饱和了,再增大批处理大小会让 GPU 陷入空转状态,是另一种层面的 GPU 浪费。
ZeRO 的另一个问题是没有处理激活值,这导致第三阶段的方案貌似能够让我们很容易地扩大模型规模,但实际上没有那么有效。而要处理激活值开销,就需要对前向传播阶段的模型参数进行切分。
流水线并行 #
这种并行方式很直观但也很匪夷所思,可以说是最不像并行的并行。直观来说,我们将模型的不同层划分给不同的 GPU,上一个 GPU 计算完成之后将计算结果交给下一个 GPU 处理。我知道你想说什么,这其中确实是有非常严重的流水线停滞问题。一个直白的解决方案就是将一个批次再划分为多个迷你批次,如下图所示。
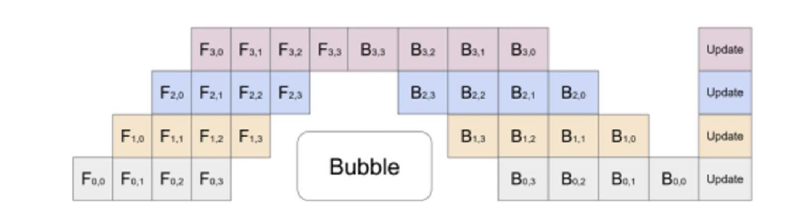
可以预计,想要让流水线并行能够高效运转,就需要巨大的批处理大小;并且效率对批处理大小的响应是非常敏感的。于是我们就可以进行复杂的流水线调度来尽可能挤掉这些停滞气泡。一个合理的问题,我们有没有办法挤掉所有的停滞气泡?还真可以。
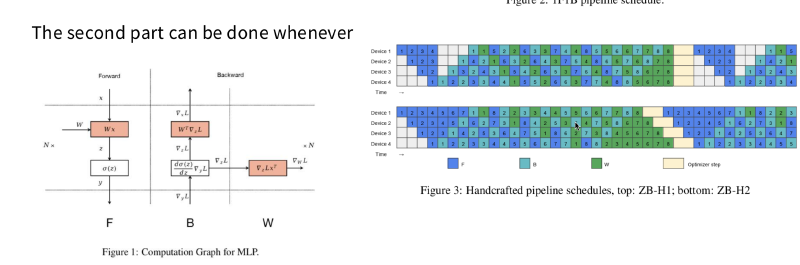
我们可以对整个训练过程进行细致分析,将反向传播分为两块,一个是对输入 \(x\) 计算梯度,另一个是对权重 \(W\) 计算梯度。前者是上一层的输出梯度因此需要尽快计算,而后者则只需要在当前反向传播这个操作内完成就行,可以随意调度来填充停滞气泡。在合适的情况下,我们能够挤掉所有气泡!
张量并行 #
张量并行的原理稍微复杂一些,如图所示。我们可以将 A 按照列切分,然后将 B 按照行切分,这样就能够减少中间通信,因为计算刚好就需要 A 的列和 B 的行。一个细节是,反向传播的时候需要对换函数 \(f\) 和 \(g\) 因为按照计算图来说确实如此。
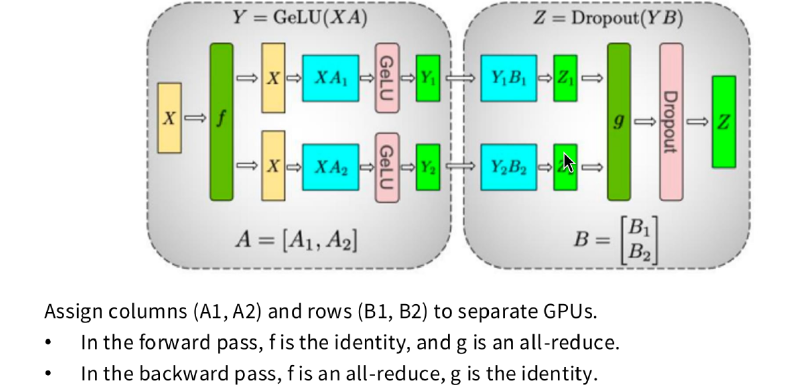
张量并行有什么弊端呢?因为其是算子级的并行策略,所以一个训练步可能要调用几百次,并且这些操作是强同步的没法用计算开销掩盖通信开销,再并且张量并行的单卡算通比非常低,无法通过加大批处理大小来摊薄成本。其中 \(tp\) 表示 GPU 数量。
$$ \text{Ratio} = \frac{\frac{16 \cdot b \cdot s \cdot h^2}{tp}}{4 \cdot b \cdot s \cdot h} = \frac{4h}{tp} $$总结下来,张量并行是非常需要通信带宽的,所以这个操作一般被认为只能够在高速局部连接(如单机内的 NVLink / NVSwitch)网络内使用。
序列并行和上下文并行 #
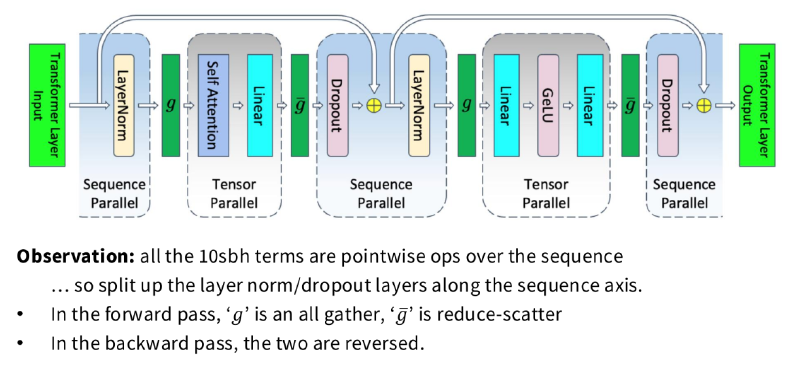
序列并行一般是应用在残差连接和层归一化部分,因为这里每一个 GPU 都会保存一份完整的激活值。具体来说就是将序列长度进行切分,这样就能够直接降低激活值。
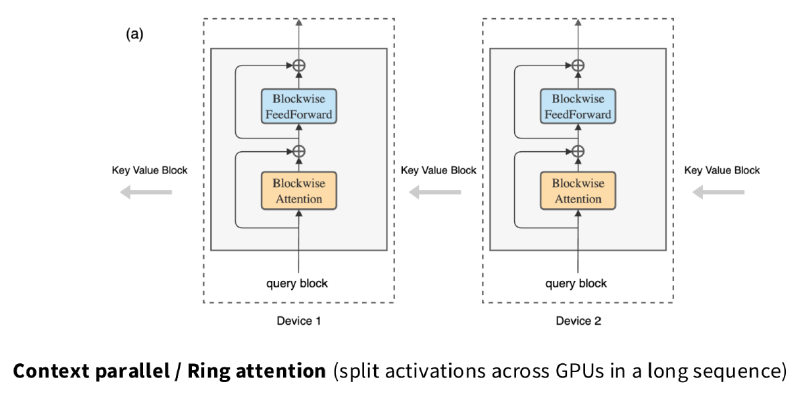
而上下文并行则在序列并行的基础上更进一步,将注意力机制中的激活也进行切分,具体而言切分的就是 KV Cache 了。这里提到的 ring attention 其实从底层实现上和 All-reduce 的底层实现类似,都是一个环形的数据分片传递。
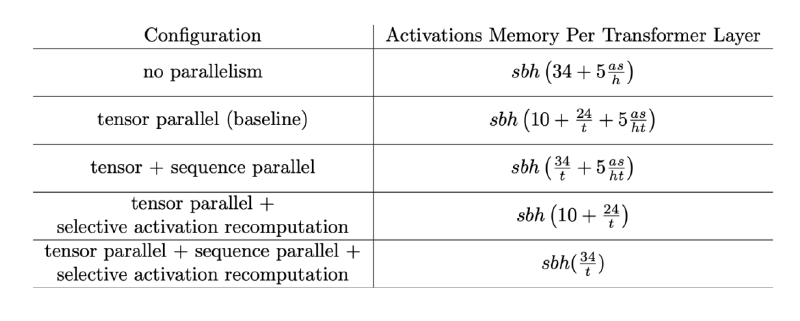
在有了上面所有模型层面的并行操作之后再辅以选择性的重计算,激活值中的所有部分全部都能够被 GPU 的数量平摊。
😂
真是一场对 GPU 酣畅淋漓的压榨啊🤣
专家并行 #
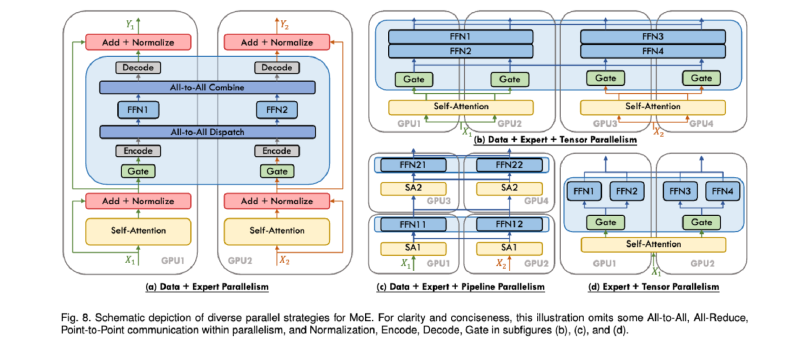
专家并行这个次比较奇怪,因为 MoE 本身好像就是并行的:不同的专家放到不同的 GPU 上,然后计算的时候就直接将中间结果路由到对应的专家就行。并且实际上也是这么做的。
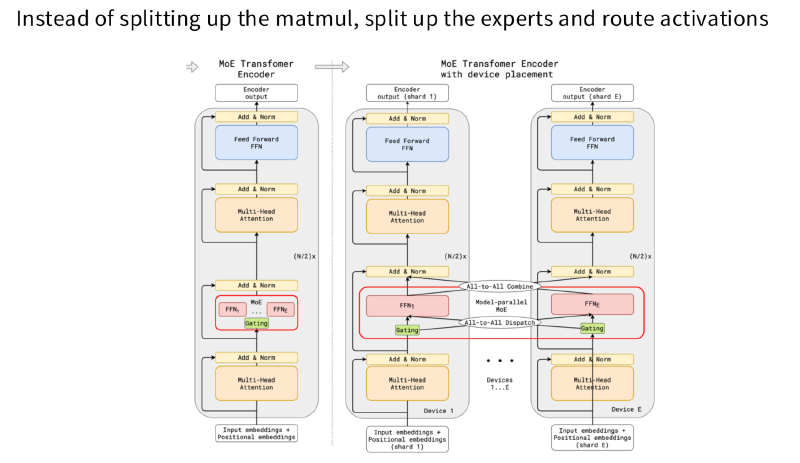
但专家并行真正的复杂性来自于与其他并行策略的复合。并且比较值得关注的是,数据并行和专家并行在底层是可以共享权重划分的,所以专家并行的数量应该不超过数据并行的数量。
注意
实际上不能够盲目地在 MoE 模型里面将数据并行和张量并行拉得非常大,因为 GPU 本身是为了大矩阵运算设计的,只有在较大的矩阵运算负载下才能够尽量达到理论预期的吞吐
混合并行 #
当我们有了那么多的细分并行方案,那么我们在具体的工程实践中如何混合从而达到最佳的效果呢?
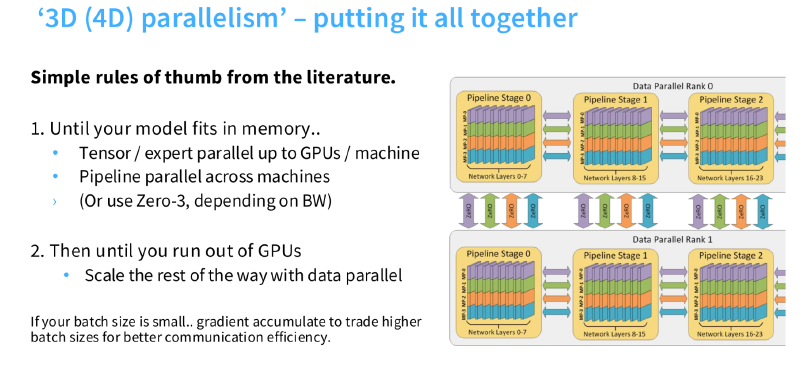
我们一般使用 3D/4D 方法来混合这些并行策略:
- 每一个黄色方框中都代表了一个 NVLink 作用域,在这个域内执行模型并行(张量并行、序列并行、上下文并行、专家并行);
- 不同的黄色方框代表了不同的模型层,不同模型层之间使用流水线并行;
- 最后复制前两个步骤得到的单元构成数据并行。
原则上来说,我们总是先使用模型并行和流水线并行解决显存放不下模型的问题(这个时候张量的大小应该刚好能够放入显存从而充分利用 GPU 在计算大矩阵运算时的效率),显存够用之后就使用数据并行吃满所有算力卡。
推理 #
LLM 训练对于算力的消耗是公认的大,但是从整个模型的生命周期来看,推理时的算力消耗占比可能更高。并且推理时的表现直接与用户体验挂钩,因此从系统工程的角度对推理阶段进行优化是非常必要的。当然,推理时的 GPU 负载与训练时有很大的不同,因此需要专门进行分析。
首先我们当然希望推理时我们的系统能够越快越好,但是这里的"快"有不同的定义。
- 首 Token 延迟 (Time-to-first-token, TTFT):从用户的空白等待时间的角度考虑,单位一般为毫秒 (ms)
- Token 速率:一条用户请求中每一个 token 需要的时间开销,单位一般为 (s/token 或 s)
- 吞吐率:从系统整体的角度来看,每秒能够产出多少 token,单位一般为 (token/s 或 \(s^{-1}\))
Token 速率是我自己的表达方式,英文标准表达是 latency 也就是一个 Token 带来的延时,但由于与 TTFT 在中文表达上有点重叠,所以中文表达就换了一个方式
推理流程 #
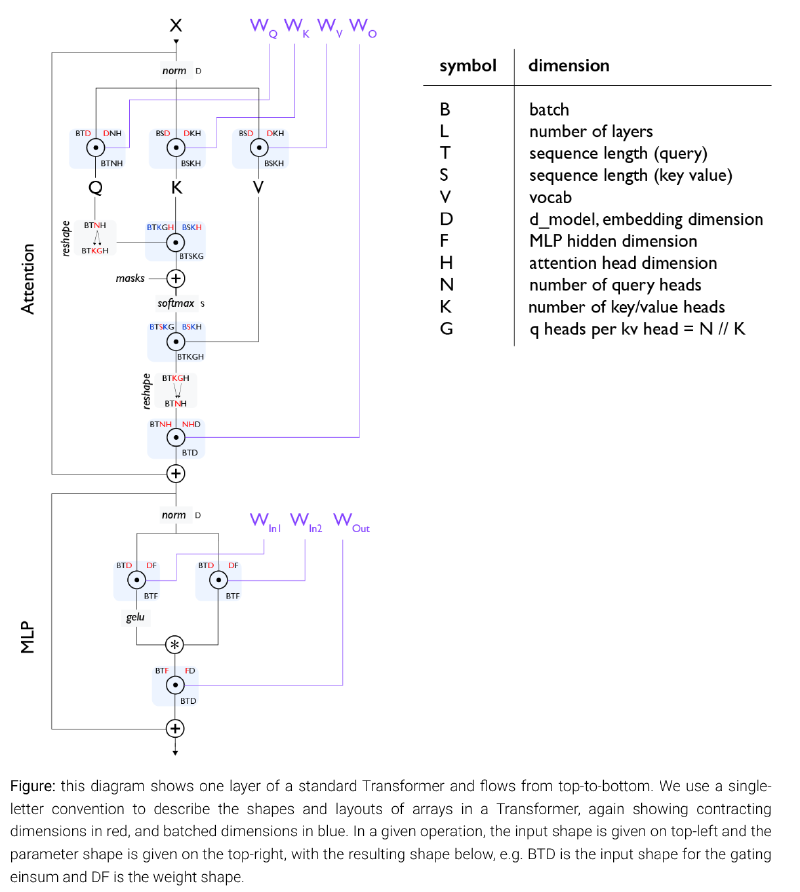
首先这里给出标准的 Transformer 架构的流程图以及其中参与运算的张量形状。具体细节参见模型架构部分。为了后续计算结果简洁,这里默认一些参数之间的关系:\(F=4D\),\(D=NH\),\(N=KG\);另外默认使用 bfloat16 作为数据精度。
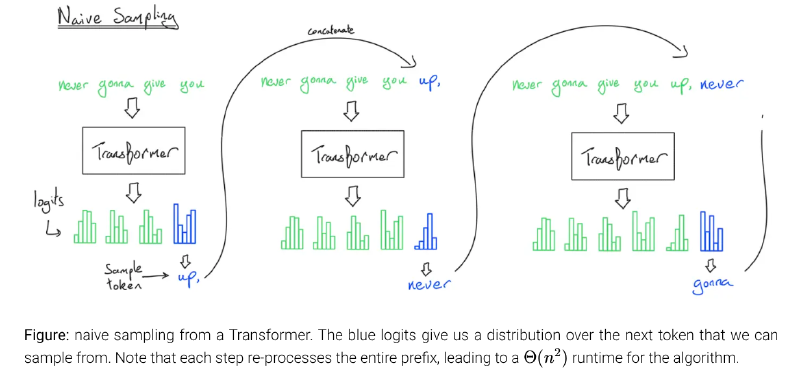
最朴实无华的推理方案如下图所示,所有的步骤都几乎与训练时一致:我们会计算得到所有位置对其下一个位置 token 的预测分布,然后截取最后一个 token 的预测分布并按照某种采样策略 (温度缩放、top-\(p\) 截断等) 去获得我们真正需要的新 token 并拼接回输入,如此往复。可以预见,这种方法在前馈层具有 \(O(n^2)\) 的复杂度,在注意力层具有 \(O(n^3)\) 的复杂度,具有大量的计算冗余。
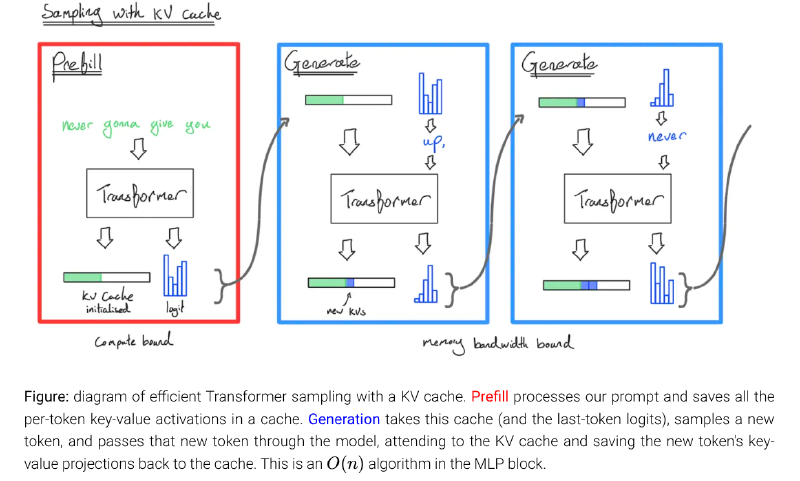
于是目前的事实标准就是使用 KV Cache 来减少冗余计算。此时我们可以对推理阶段进行更细致的划分:
- 预填充阶段:与训练时类似,因为此时我们需要处理一段较长的已知文本,获得最终的预测分布,同时将 \(K,V\) 张量进行缓存,用于与下一个新 token 计算注意力分布
- 生成阶段:每次都产生一个新的 token 并缓存该 token 的 \(K,V\) 张量
计算强度分析 #
前馈层的计算流程大致是:加载注意力模块的计算结果 \(X\) 形状为 \((B, T, D)\),加载上采样投影张量 \(W_{u}\) 形状为 \((D, F)\),加载门控张量 \(W_{g}\) 形状为 \((D, F)\),加载下采样投影张量 \(W_{d}\) 形状为 \((F, D)\);计算 \(X\) 与 \(W_{u}\) 的乘法并将计算结果 \(U\) 写回 HBM,计算 \(X\) 与门控 \(W_{g}\) 的乘法并将结果 \(G\) 写回 HBM;读取刚刚的两个计算结果,对 \(G\) 计算逐元素 GeLU 激活然后与 \(U\) 计算逐元素乘,最后与 \(W_{d}\) 计算乘法并将结果写回 HBM。
统计所有的数据搬运 (\(20BTD + 24D^2\ \text{Bytes}\)) 和实际计算量 (\(24BTD^2\ \text{FLOPs}\)) 可以得出最终前馈层的算数强度为
$$ I = \frac{24BTD^2}{20BTD + 24D^2} = \frac{6BTD}{5BT + 6D}\text{ FLOPs/Byte} $$在预填充阶段,前馈层的典型表现是批量大小和序列长度非常大,此时算数强度趋近于 \(1.2D\) 几乎肯定能够达到 GPU 的理论负载;即便批量大小和序列长度没有那么大,也是能够非常轻松地满足理论负载的 (需要一点点数学估算)
H100 相关数据
H100 的计算能力为 \(9.89\times 10^{14}\),内存带宽为 \(3.35\times 10^{12}\),设计上的算数强度最大为 295;换言之,我们期望达到这个算数强度以充分利用 GPU
在生成阶段的话,如果我们假设每一次都只生成一个 token 的话 (\(T=1\)),前馈层也是有一点点问题的:\(B\) 取决于用户 (不论是多用户并发还是单用户并发) 不是系统工程能够解决的问题,极端情况下的算数强度很低。但其实对于目前主流的大模型应用而言 (用户比较多),我们总是能够将用户的请求拼接从而获得一个较大的 \(B\) 从而高效利用 GPU (详见动态负载)
暂时不考虑分组优化,默认使用 FlashAttention,注意力模块的计算流程大致为:读取输入 \(X\) 形状为 \((B, T, D)\),读取三个投影矩阵 \(W_{Q}, W_{K}, W_{V}\) 形状为 \((D, D)\),计算三次张量乘法得到 \(Q, K, V\) 形状均为 \((B, T, N, H)\),这里计算得到的 \(K, V\) 需要写回 KV Cache,\(Q\) 驻留片上;然后 \(Q\) 与全局缓存中的 \(K_{\text{all}}^T\) 形状为 \((B, S, N, H)\) 进行张量乘法再经过缩放、因果掩码、softmax 计算以及与全局缓存中的 \(V_{all}\) 进行张量乘法 (使用了 FlashAttention 就没有中间结果的写回和读取) 最终结果写回输出张量 \(O\) 形状为 \((B, T, N, H)\)。
统计所有的数据搬运 (\(8BTD+6D^2+4BSD\ \text{Bytes}\)) 和实际计算量 (\(6BTD^2+4BTSD\ \text{FLOPs}\)) 可以得出最终注意力层的算数强度为
$$ I = \frac{3 \frac{D}{S}+2}{\frac{4}{S}+3 \frac{D}{BTS}+\frac{2}{T}} $$在预填充阶段,\(T=S\) 以及 \(B\) 都是比较大的,几乎都能够达到甚至超过 \(D\) 的量级,可以非常轻松地达到目标算数强度;即便是考虑动态负载 \(B\) 可能会变化也影响不大。
在生成阶段,此时我们认为 \(T=1\),即便 \(S\) 非常大极限情况下算数强度也只能够达到 1,这是非常糟糕的!
通过对算数强度的理论分析,一个结论就是:注意力模块在推理时的 GPU 利用率相当地并且单纯从参数调整的角度没法改进需要机制的创新🤔
性能指标分析 #
通过对于算数强度的分析,我们知道了推理阶段主要是内存受限的,因此在理论分析 Token 速率和吞吐率的时候我们可以忽略计算开销从而获得简明的结果。并且在实际工程中,推理时一般会使用一种超大的算子融合技术从而尽量避免数据写回,所以在之前分析算数强度的时候一些细节的访存开销就可以忽略不计了 (数值估计只有千分之几),此处的分析只考虑两个访存开销:模型参数和 KV Cache
模型参数量的估计遵循下面这个公式,在不适用分组查询注意力方案的时候 \(K\) 和 \(N\) 是相等的:
$$ \text{Param} = \underbrace{2VD}_{\text{Embedding \& LM Head}} + \underbrace{3DFL}_{\text{MLP}} + \underbrace{\Big( \underbrace{DNH}_{W_Q} + \underbrace{2DKH}_{W_{K,V}} + \underbrace{DNH}_{W_O} \Big) L}_{\text{Attention}} $$而 KV Cache 的大小遵循这个公式:
$$ \text{Memory}_{\text{KV}} = \underbrace{2}_{\text{Key \& Value}} \underbrace{P}_{\text{Bytes/Elem}} \underbrace{BS}_{\text{Tokens}} \underbrace{L}_{\text{Layers}} \underbrace{KH}_{\text{KV Dim}} $$理论上的 Token 速率可以理解为所有这些访存开销所需要的时间,也就是产生一个 Token 所需要的时间:
$$ \text{Latency} = \frac{\text{Param}+\text{Memory}_{\text{KV}}}{\text{Mem\_bandwidth}} $$从系统批处理的角度来看,整体吞吐就是:
$$ \text{Throughput}= \frac{B}{\text{Latency}} = \frac{B \cdot \text{Mem\_bandwidth}}{\text{Param}+\text{Memory}_{\text{KV}}} $$代入 Llama2-13B 模型的具体参数可以得到如下表格。
| Batch Size | num_params |
memory (Bytes) |
latency (s) |
throughput (tokens/s) |
|---|---|---|---|---|
| b1 (\(B=1\)) | 13,015,449,600 | 26,869,760,000 | 0.0080 | 124.6755 |
| b64 (\(B=64\)) | 13,015,449,600 | 79,717,990,400 | 0.0238 | 2689.4807 |
| b256 (\(B=256\)) | 13,015,449,600 | 240,779,264,000 | 0.0719 | 3561.7685 |
可以看出 Token 速率与吞吐率这两个指标其实是矛盾的:增大 \(B\) 会导致延时增大但整体吞吐也会同步提高,所以这里就需要去平衡两者。
首 Token 延迟这个指标还没有讨论,但简单一点可以理解为预填充阶段耗时和单次推理耗时的总和,两个部分都与 \(B\) 正相关,所以增大 \(B\) 同样会增大首 Token 延迟。
有损提速 #
为了提高推理的速度,我们可以从两个方面来思考:KV Cache 和模型本身;这两个部分也是上面性能指标分析部分计算的重点。
为了压缩 KV Cache,一个直接的方案就是在多头注意力分头的时候解耦 KV 头和查询头 (分组查询注意力),例如查询头分为了 8 个每一个头 128 维,标准做法是 KV 部分也分 8 个头每个头 128 维,分组查询的方案就是 KV 部分只分 4 个头并且每一个头也还是 128 维,KV Cache 直接减少一半。并且实验结果表明,只要不退化为单头 KV,这种做法的性能损失是可以接受的。
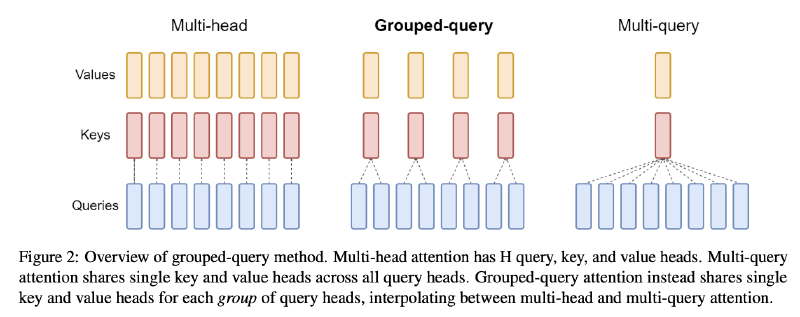
DeepSeek 的系统工程做得是非常硬的,其也对 KV Cache 进行了非常精妙的压缩,方案名称为多头潜在注意力。每一个 Token 产生 KV 之后不分头直接经过一个压缩矩阵缓存为更小的压缩 KV,然后使用的时候每一个头都配备一个还原矩阵,需要计算的查询 Token 先与还原矩阵结合之后直接与压缩 KV 进行乘法。这样我们可以对 KV Cache 的压缩率进行更加细致的调节 (相比于分组查询更细致)。另外值得一提的是,这种压缩操作最终的性能评分甚至更高了,真正意义上的双赢!
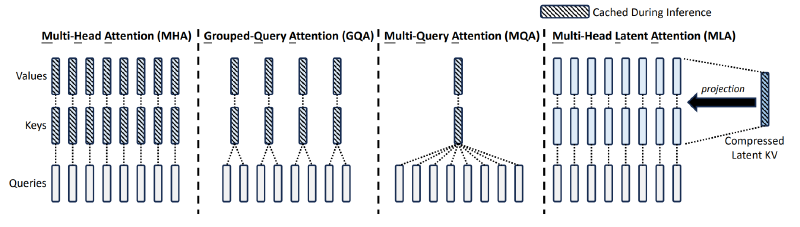
当然,还有别的一些 KV 压缩技术包括跨层连接注意力,滑动窗口注意力,甚至还包括大部分线性注意力的相关方法,不细致展开了。
从模型层面,一般来说可以做两种操作:模型量化和模型剪枝蒸馏。
量化直白来说就是将高精度的数值用低精度的数值表示,一个直观的理解方式就是:想象一个稀疏的二维网格,高精度的数值点散落在网格中间,量化就是将这些数值点吸附到网格上面去。量化具体又细分为:
- 训练时量化:在训练阶段就执行量化和反量化,模拟推理时的真实量化损失;缺点是训练成本会提高很多,不只是计算开销,引入误差之后还会降低收敛速度和最终效果从而需要更大的数据量和 GPU 小时
- 训练后量化:训练完成后,在一批样本数据上去调整量化方案,成本更低并且效果没有差太多 Frantar+ 2022
- 注意力量化:思路就是越大的数值约需要高精度 (因为注意力分数会与其他数值进行乘法交互) Lin+ 2023
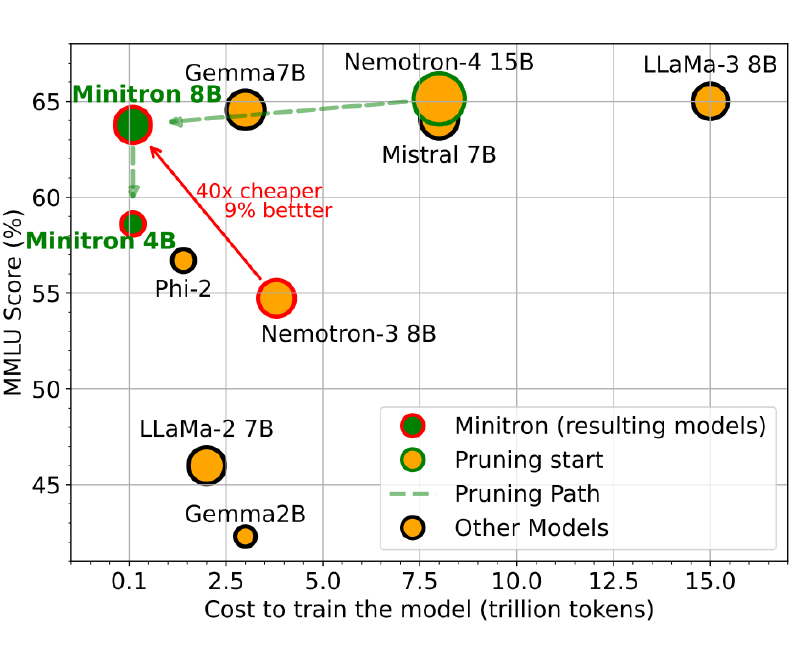
模型剪枝蒸馏这个方案代表性的工作就是英伟达的 Nemotron4-15B 和 Minitron-8B (Muralidharan+ 2024)
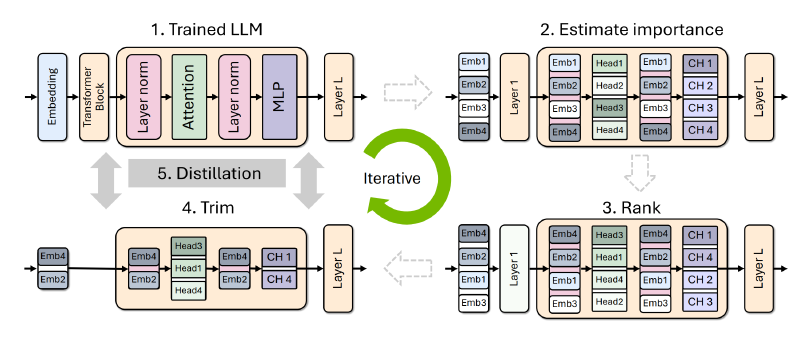
最终的效果也非常惊艳,通过模型剪枝得到的 Minitron-8B 小模型比直接预训练得到的 Nemotron3-8B 模型成本更低效果更好!
无损提速 #
上面的方法从某种程度来说其实都压缩或者改变了 KV Cache 或者模型本身的参数,虽然最后结果可能更好 (多头潜在注意力方案),但我们有没有办法能够实现无损的提速呢?目前唯一的方案就是使用投机解码技巧🤔
投机解码其实就是利用了预填充阶段也能够产生每一个位置对下一个位置 token 的预测概率分布,这个事实表明检测一个 token 的概率是否够高是比生成一个 token 更便宜的。这是一个典型的猜错了惩罚小,猜对了收益大的场景,类似于 CPU 流水线设计中的分支预测。
具体来说,我们可以使用一个推理速度更快的小模型去一次性预测后面多个 token,然后使用原本的模型去检测小模型生成的 token 是否可行,大部分情况下是部分可行的 (比如投机解码了 4 个 token 最后验证得到 2 个 token 是可行的),那么此时又顺便利用验证得到的预测分布去修正第一个不可行的 token,小模型获取到新的 token 后就能够继续去投机预测下一批 token。这里有一个比较直观的演示动画。
通过对方法的理解,相信不难理解为什么这种方法是无损的,因为每一个 token 都经过了原本模型的校验
一个有意思的问题是:原本的模型与小模型预测的概率分布的相似度至少需要多少才能够获得正向的收益?这里可以产生一段的比较宽松数学推导,感兴趣的话可以去练练手。最终的结论是:两个模型的分布重合度 \(\alpha\) 是少要达到大模型与小模型的速度比 \(c\) 才可能有正向的收益。
$$ \alpha = \mathbb{E}_{x \sim Q} \left[ \min\left(1, \frac{P(x)}{Q(x)}\right) \right] = \sum_{x \in \mathcal{V}} Q(x) \min\left(1, \frac{P(x)}{Q(x)}\right) = \sum_{x \in \mathcal{V}} \min(P(x), Q(x)) $$其中 \(P(x)\) 表示大模型推理得到的概率分布,\(Q(x)\) 表示小模型得到的概率分布,\(\mathcal{V}\) 表示词表。当然这个理论推导是非常宽松的,实际上在 \(c \approx 0.1\) 时小模型在主流基准测试上的 top-1 命中率需要达到 \(65\%\) 以上才能够带来大约两倍的速度提升。
动态负载 #
从系统工程的角度我们能做的一般就是增大批处理大小 \(B\),但是推理时的动态负载是一个比较棘手的问题。如下图所示,推理时不同的请求到达的时间不同,长短也不一致。Orca 给出的方案就是:将调度的粒度变得更小,以一次前向迭代为粒度进行调度,一旦某一个请求输出了终止 token,新的用户请求就可以混入现有的批次进行计算。
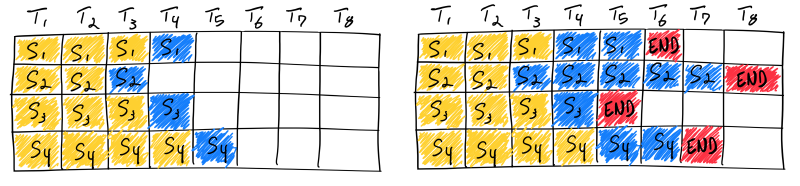
一个显而易见的问题是,标准的张量运算需要保证张量本身是一个完整的高维立方体,这种残缺的张量如何处理呢?Orca 给出了一个巧妙的思路:Transformer 除了注意力模块之外,Token 之间没有相互依赖,可以直接在序列长度这个维度上进行拼接;对于注意力模块确实没办法,需要每一条序列单独处理。
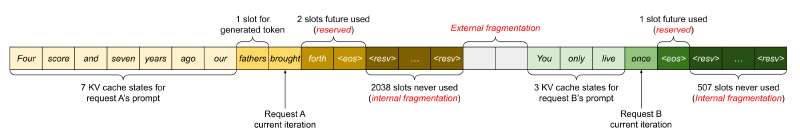
vLLM 的 paper 则将单个请求内部的空闲碎片消除,从而允许显卡处理更大的批量大小。如下图所示,可以直观理解内部碎片和外部碎片是如何产生的:内部碎片是我们为每一个用户预分配最大输入长度的显存时产生的碎片 (实际上用户很有可能用不完);外部碎片的产生与操作系统中的情况类似,动态请求不断进出导致显存块碎片化无法承接一个正常的负载。
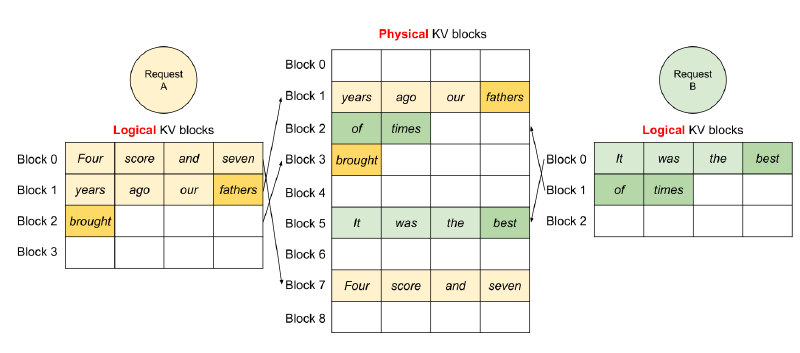
分页注意力机制如其名,大体上的思路就是使用分页方案,将一个请求的显存占用切分为不同的块存储到非连续的物理存储中,这样显存的利用率可以实现巨大的提升 (\(40\%\) 到 \(96\%\));并且这种方案还带来了一个额外的好处,不同请求中相同的片段可以共享显存块,这更进一步降低了单次请求的显存开销,提升了系统整体的吞吐。
规模定律 #
在民间理解中,规模定律更类似于一种断言:不断地扩大模型的规模,投喂更多的数据,性能就可以不断提升。实际上这种观点应该被称为规模效应而非规模定律,因为规模定律可以给出更具价值的信息,能够利用小规模实验的结果去外推预测大规模实验的结果。
假设你是一个拥有万卡集群的公司的总工程师,现在公司要求你在一个月内训练出一个 SOTA 大模型来,你应该怎么设计模型的架构?如何分配 GPU 小时?更关键地,你如何给出一个定量的预测?你总不能说因为你这次扩大了训练规模、增加了数据量最终的模型就一定更好吧?毕竟一次大规模训练是非常昂贵的。所以这就是规模定律真正的价值所在。
数据规模定律 #
经过大量的实践发现,模型的误差与数据量常常是一种幂律关系 \(\text{loss}=c n^{-\alpha}\)。为什么误差与数据量的关系常常遵循幂律?一个直观但是不太严谨的思路就是,假设一个足够简单但足够通用的学习任务,比如我们想要根据一维高斯分布的采样 \(x_{1}, x_{2}, \dots x_{n} \sim N(\mu, \sigma^2)\) 去推断其均值,我们知道最优的推断就是这 \(n\) 个样本的平均值
$$ \hat{\mu}=\frac{\sum_{i}^{n} x_{i}}{n} $$那么此时的误差可以表示为
$$ E[(\hat{\mu} - \mu)^2] = \frac{\sigma^2}{n} $$在双对数坐标轴上就表示为
$$ \log(E[(\hat{\mu} - \mu)^2]) = -\log n + 2 \log\sigma $$可以看出是非常精确的线性关系,因此如果我们认为大多数任务都是线性可叠加的,那么误差与数据量的关系就应该是在双对数图上的一条直线。
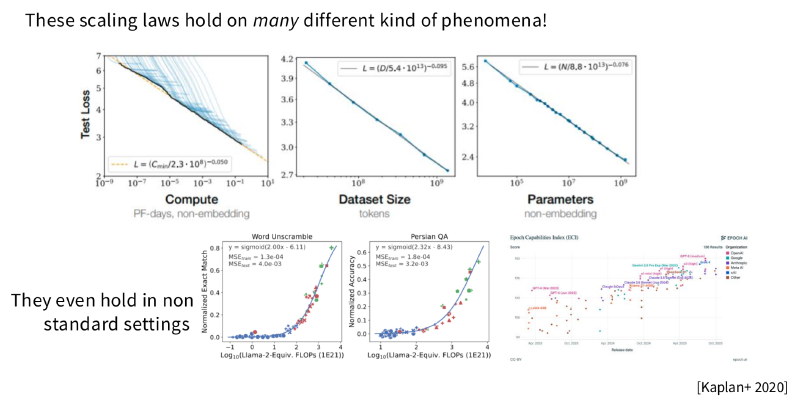
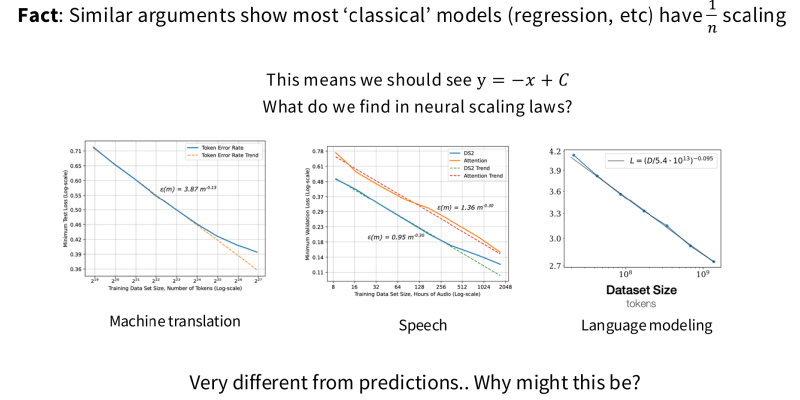
好的,那么我们目前可以理解为什么是幂律关系,但这个斜率是多少呢?在刚才那个简单的例子中这个指数是 \(-1\) 那么是否所有的学习任务都是 \(-1\) 呢?实际上,在不同的任务上测试得到的数据非常不同,斜率是远远低于常规预期的。
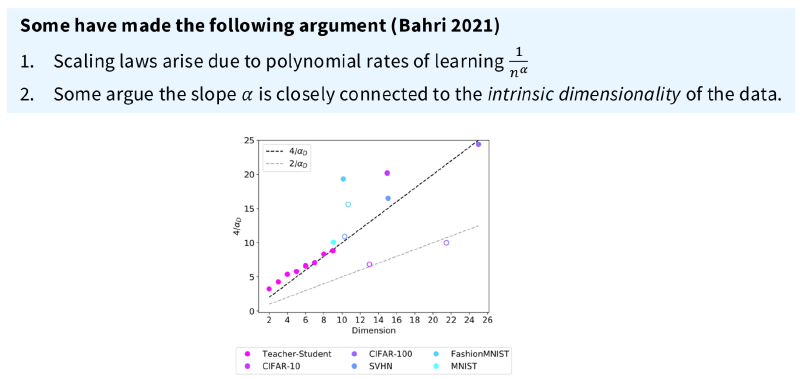
一个比较合理的解释是:幂律的指数(双对数图中的斜率)取决于数据的本征维度。这里其实就是比较著名的流形假说的一个推论:数据点的分布其实是镶嵌在高维空间中的低维流形,数据的本征维度就是这个流形的维度。但实际上这种对本征维度的测量是不太准确的,所以这种说法也并非那么无懈可击。
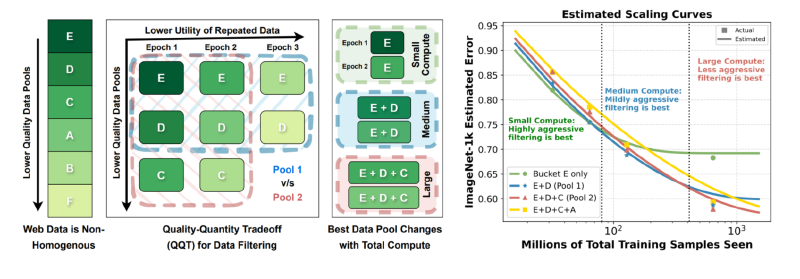
另一个在工程中比较值得关注的话题是:数据的配比是否会影响模型的训练效果?经过大量测试可以得到一个比较确定的结论:不同数据配比会影响截距但不会影响斜率。那么我们有没有办法得出不同数据配比的一个规模定律呢?实际上是非常困难的,因为不同的数据之间存在复杂的正负迁移效应,最终预测的成功率非常低。
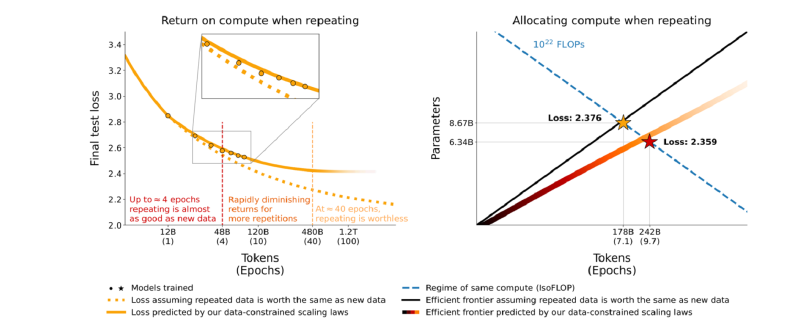
既然调配数据的预测比较困难,那么高质量数据重复利用是否更容易预测?确实是更加容易预测,而且结论表明重复四次左右的效果和全量新数据一样有效。
最后总结下来,我们应该怎么去选择数据?算力小的时候,只用极高纯度的数据;算力极大时,应该放宽过滤标准,吸纳更多中等质量的数据。
模型规模定律 #
在模型层面我们希望得到这一些问题的答案:不同模型的类别(LSTM vs Transformer)如何选择?优化器如何选择?在资源有限的情况下,更深的模型好还是更宽的模型好?收集更多数据还是去配备更多的 GPU?
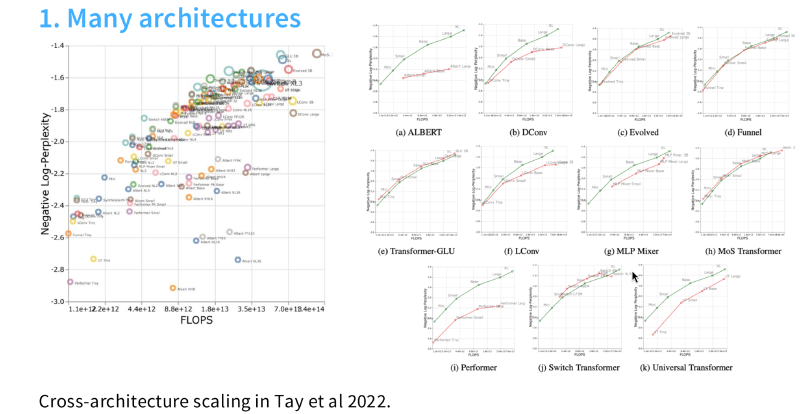
首先是模型选型方面,并没有一个比较简明的公式可以供我们直接代入,基本上都是将各种各样的模型都小规模测试一遍。
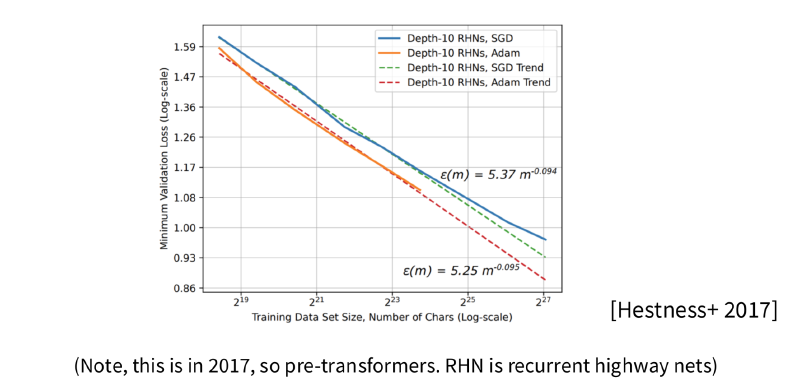
优化器选型方面,不同的优化器对应的斜率基本相同,差距只是截距。但是这个研究结果已经是非常早期的结论了,因此工业上一般都默认使用 Adam 优化器了。
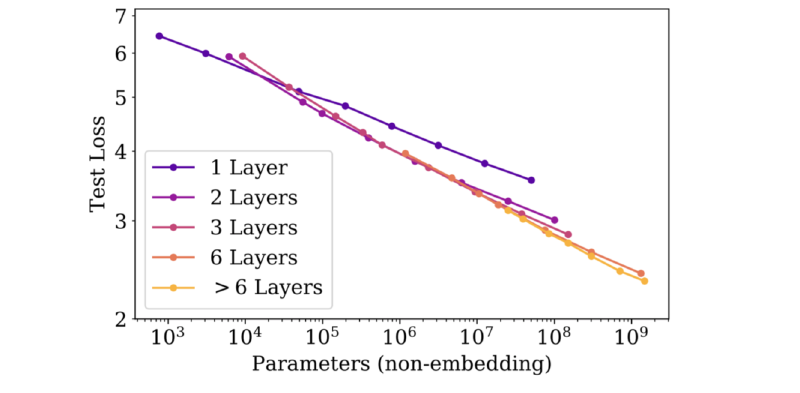
模型深度的选择也有一个比较明确的结论:只要模型深度不太小,越深的模型效果越好但是收益递减。
模型的宽深比随着模型的规模变大有一个缓慢的减小,但整体上来说 100 左右的宽深比是比较稳妥的。
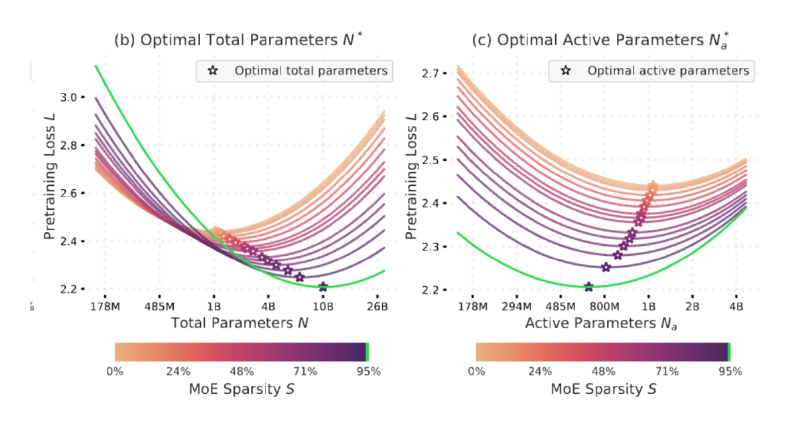
MoE 方法目前已经成为了默认选项,所以 MoE 相关的规模定律也是需要关注的,但简单来说就是模型越大越好。
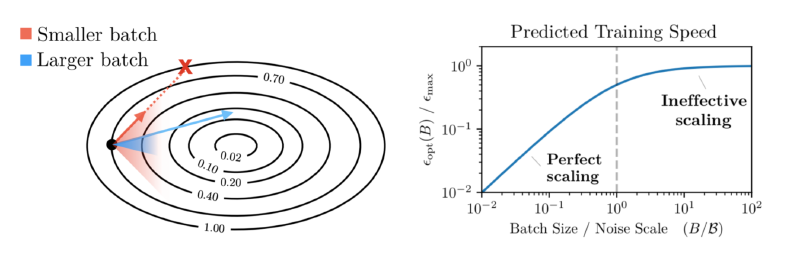
模型训练的批量大小也是一个重要的参数,当批量大小达到某一个阈值之后,继续增大批量并不能够有效降低梯度的噪声。这个阈值的大小可以通过实验来测定,大致就是选定一个合适的损失值,然后测试达到这个损失值需要的反向传播步数和需要的样本总数量,然后计算最小值的比值 \(\frac{E_{\text{min}}}{S_{\text{min}}}\) 即作为这个临界批量大小。
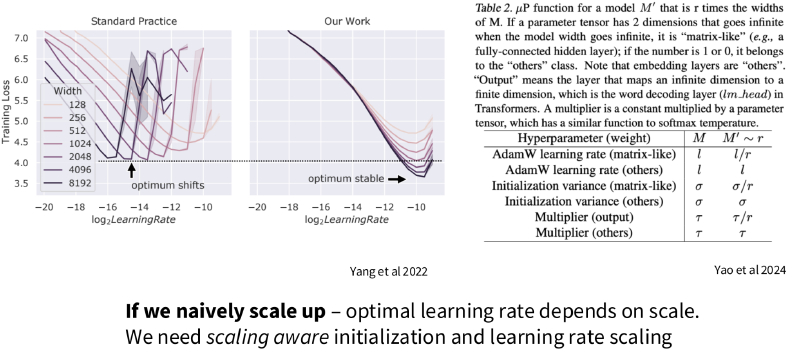
最后学习率也是需要随着模型规模扩大而改变的,一个比较好的方案是使用 \(\mu P\) 这篇论文提供的学习率方案,能够比较稳定地推进损失前沿。
不同参数 #
不同参数对于规模的响应是不同的,这一点是非常容易忽视的。特别是嵌入层的参数,其表现和其他层的参数不太一样。
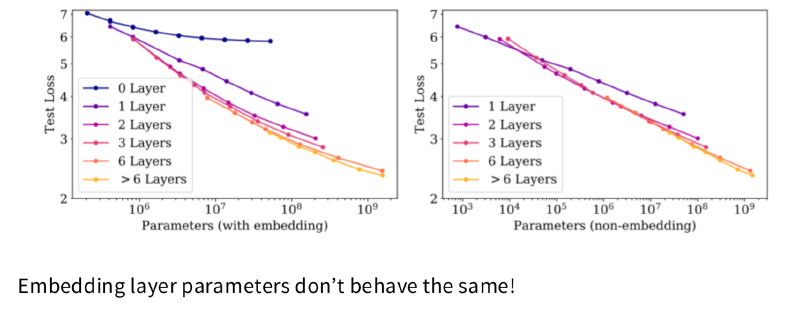
总结 #
最后总结一下吧,规模定律这个话题其实非常繁琐嘈杂,但这一节最核心的思路其实一开头就提出来了:用一些小规模的实验来外推大规模的结果。虽然罗列了很多论文的实验结果,但是真正想要落地到工业实践中去,一般来说还是需要重新进行小规模的实验来获得更准确的外推表现。
数据工程 #
基准测试 #
基准测试的一个重要用途就是用于评估模型到底有多"好”?当然,“好"是一个非常抽象的表述,我们需要将我们的需求转化为明确可测量的指标,这也是基准测试构建的一大难点。
困惑度 #
困惑度是量化模型表现的一个最为简单直白的指标,因为模型训练的目标就是最小化训练集上的困惑度,理所当然我们用测试集上的困惑度来刻画模型的语言能力。
目前主流观点对困惑度这个指标有不同的两种看法:
- 困惑度就是一切:如果我们的数据集能够反应真实的数据分布,那么我们不断地优化困惑度就能够最终实现 AGI
- 困惑度并非一切:困惑度认为所有的 token 都具有相同的信息量 (重要程度),但实际上显然并非如此
观点
我目前倾向于第二种观点,因为我感觉第一种说法是存在逻辑错误:我们的数据集当然能够很好地反应自然语言的真实分布,但我并不认为语言本身是一个能够充分反应世界真实状态的表示形式。换言之,我在这里提出一个假设:如果我们纯粹使用语言去逼近世界的真实状态的话,那么我们可能需要比指数级更快的数据量增长。
考试 #
与人类参与的考试类似,在构建测试的时候我们能够控制考试的主题和难度,并且为了评分准确,我们期望考试中的问题有唯一的正确答案。下面就展示一些经典的考试基准测试。
Massive Multitask Language Understanding (MMLU),考试的科目总共有 57 个,模型需要从多个选项中选择出正确的那一个,类似下面这个例子。除了名字,这个这个测试考查的重点其实和语言理解没什么太大关联。🐸
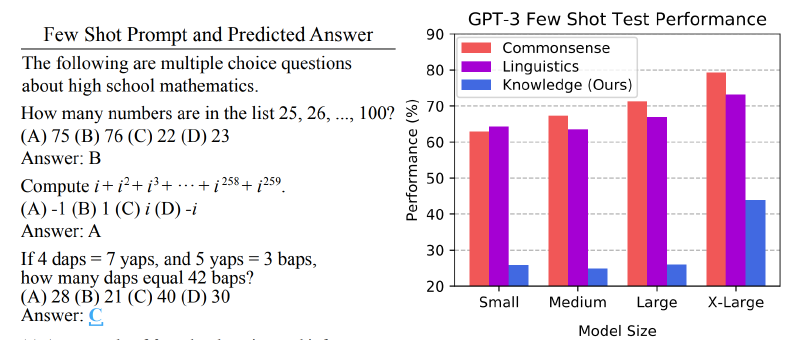
当然这个基准测试几乎可以说被刷饱和了,这是 2026 年 10 月 24 日的数据结果
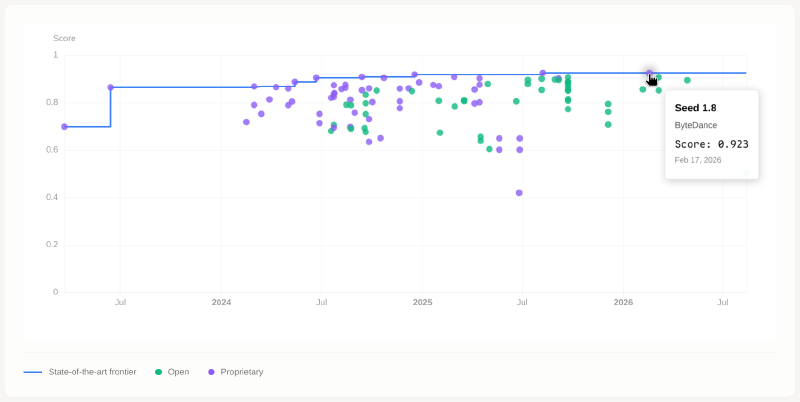
当最初的 MMLU 被刷饱和之后,MMLU-Pro 被构建出来,其将选项数量从 4 增加为 10 并将一些过于简单的问题移除了。当然这个基准测试目前也已经近乎饱和了。参见这里的数据。
随着 AI 的能力越来越强,在 2025 年构建了 Humanity’s Last Exam (HLE) 基准测试,这个测试非常广为人知,难度如其名,属实是相当高的。
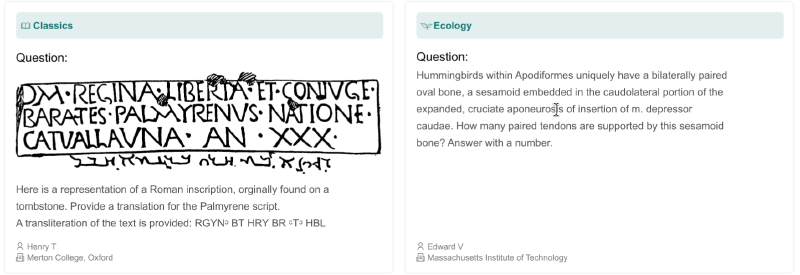
即便是到现在这个基准测试也没有达到真正意义上的饱和,下面是 2026 年 10 月 24 日的数据结果
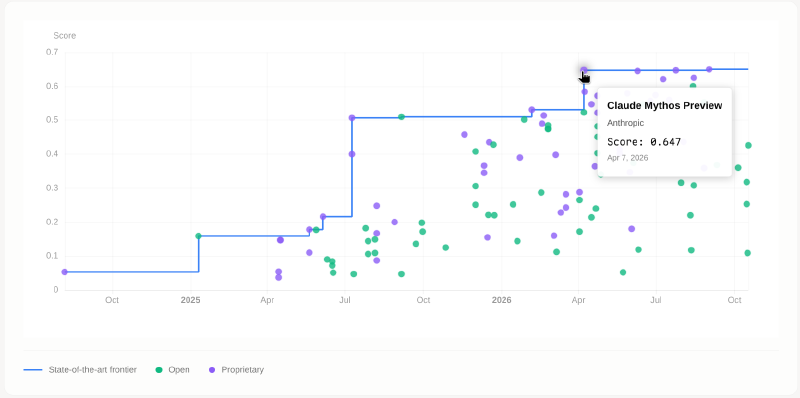
总结一下,考试形式的基准测试随着模型能力的提升变得越来越难,但考试本身并和用户实际使用的场景是脱节的:用户的问题并不一定有明确的正确答案。在这种情况下,考试测试得出的结论就和实际体验可能存在比较明显的差别了。
对话 #
在浏览器中与模型对话是用户实际使用的一个重要场景,但在这个场景中存在大量的开放性问题,如何去评估模型对这些开放性问题的回答是一个需要解决的问题。
Chatbot Arena 的解决方案是:避免让人类或者其他模型去直接评价受测试模型的输出,互联网上随机的人带着自己的问题,得到两个随机模型的回答,然后由提问者来评价哪个模型的回复更好。基于这些数据,我们就可以仿照棋类游戏中的定级规则来得到不同模型的综合能力的评分。
Arena 的一个重要的又是就是:不存在一个有偏的评价者来评价这些开放性问题。但由于参与测试的提问者具有很强的随机性,并不能够保证全面覆盖模型真实面对的用户;并且提问者需要根据自己的评价标准去辨别两个模型的输出结果,不同的评价之间可能存在冲突;另外 Arena 对于模型的评分是需要时间的,对比考试形式的基准测试,其及时性相对较差。
针对开放性问题,还有另一种主流的做法:用一个较强、较为公正的模型去统一评判开放性问题的答案。例如 AlpacaEval (2023) 和 WildBench (2024),他们都使用了 GPT-4 或者同系列的模型作为裁判。
有很多这种类型基准测试都会去统计一下自己的测试结果与 Arena 的相关性。一则是说明基准测试自身的有效性,二则从某种程度上来说解决了 Arena 评分滞后的问题
智能体 #
智能体基准测试最大的特点是:基准测试不仅测试了模型本身的能力,也测试了 Agent 框架的质量。从这些测试结果中就可以发现,Agent 框架对模型实际表现的影响甚至和模型本身一样大!并且由于 Agent 框架极大地扩展了文本接口的能力,所以智能体基准测试的内容是相当丰富的,基本上其考核要求和人类参与者是平齐的,从某种程度上说,你可以将 LLM 和 Agent 框架的组合当成一个独立的人类个体去调度。
纯推理 #
纯推理基准测试的一个出发点是:或许我们想要去衡量模型的智力而不是知识量,尽管知识量也是一个非常重要的标准。我们可以设计一些特殊的测试问题,剥离掉背景知识对解题的影响从而获得更纯净的结果。
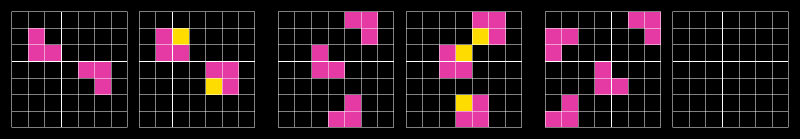
比较有代表性的测试就是 ARC-AGI-1 (2019),其形式上看起来像是一个多模态少样本推理问题
在 2025 年有推出了 ARC-AGI-2,其问题难度得到了非常大的提升
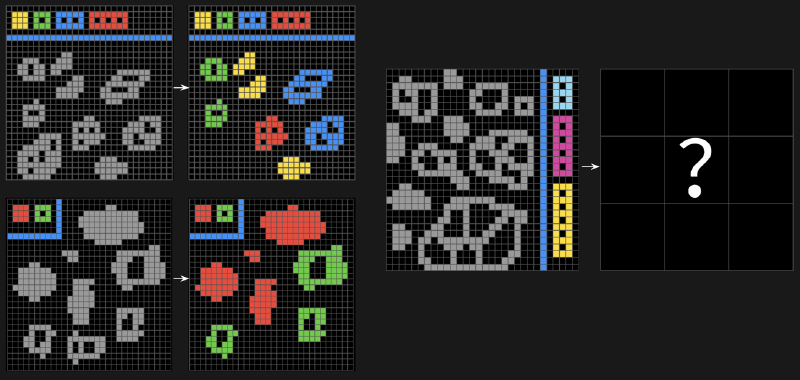
不够目前来看,这两个测试都已经饱和了 (测试结果汇总见论文图一),于是在今年 (2026) 又推出了 ARC-AGI-3,其最大的特点就是引入了交互式测评环境,类似于早期的游戏掌机。
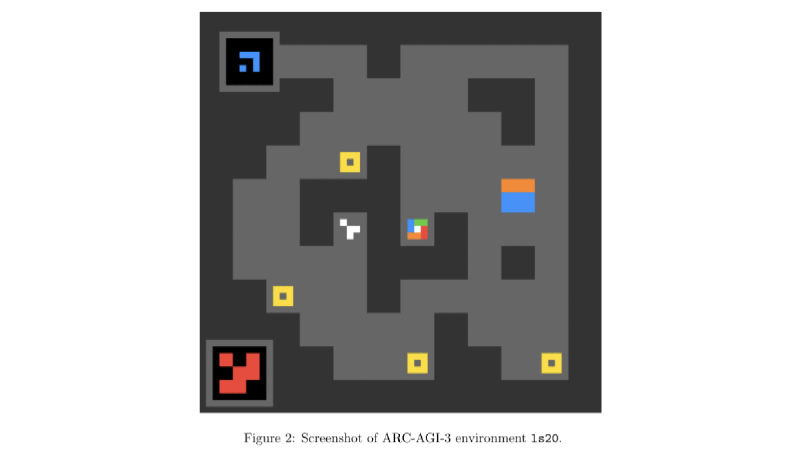
我们真的能够去剥离智能与知识吗?这种游戏掌机形式的测试是否本身就具有极强的知识先验?🤔
安全 #
安全这个词本身也并不清晰,一个比较广义的理解就是:模型不应该输出违背道德法律或者威胁全人类的信息,当用户有类似的提问的时候应该拒绝回答。
这里的基准测试相对智能体部分较少,比较经典的有:HarmBench (Mazeika+ 2024) 和 AIR-Bench (Zeng+ 2024)
训练-测试重合 #
机器学习入门准则中就有一条:不要在测试数据上训练模型。这在大模型时代之前是非常显然的,但在现在却是一个困难的问题:模型训练的数据集太大,你几乎不可能做到 100% 的干净。
应对这个问题大致有几种思路:
- 使用某种方法去检测模型的训练-测试数据重合:利用测试问题本身的可交换性,如果模型对某一特定的问题顺序表现出显著更低的困惑度,那么就能够证明其存在数据重合 (Oren+ 2023)
- 模型的训练者应该提供重合度分析报告 (Zhang+ 2024)
- 在私有数据集上进行测试,当然这样成本就比较高了;并且进行测试总是要将测试数据发送出去的,只能够希望模型公司不会存一个备份🐸
小结 #
基准测试的意义是明显的:告诉我们一个模型的能力究竟有多强。但实际运用起来是困难的,单个数据集总是有偏的,和我们的需求也并不一定对齐。所以一个比较准确的结论就是:如果一个模型在特定的数据集上表现突出,你需要留一个心眼;如果一个模型在各种各样的数据集上都表现良好,那么这个模型大概率是一个非常好的模型。


